登录状态:
``` 当用户名和密码匹配时 (假设用户名和密码都是 `yancey`), 返回给客户端一个 cookie 以及登录成功的 json; 否则返回登录失败的 json. 下面是模拟服务端登录的接口. ```js router.post("/login", (req, res, next) => { const body = req.body; if (body.userName === "yancey" && body.userPwd === "yancey") { // 设置 cookie res.cookie("yancey", "success"); res.json({ success: true, msg: "登录成功", }); } else { res.status(401).json({ success: false, msg: "用户名或密码错误", }); } }); ``` 通过这个例子可以看到, 在 express 中, setCookie 的方式为: 第一个参数传递 `name`, 第二个参数传递 `value`, **注意浏览器会将元字符和语义字符之外的字符进行转义**. 打开 Chrome 的开发者工具, 就可以看到该 cookie 被添加到浏览器上了. 或者你在控制台输入 `document.cookie`, 同样可以看到 cookie 字符串. 这只是一个设置 cookie 的简单例子, cookie 有 7 种属性可供使用, 我们一一来了解. 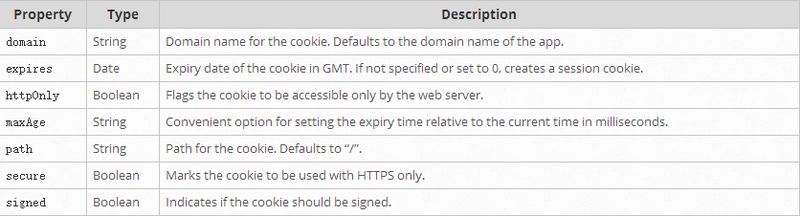 #### domain 该属性给 cookie 设置 `域名`, 默认为当前网站的域名, 下面的例子将 domain 设为 **yanceyleo.com**, 由于前端页面是 `127.0.0.1`, 根据同源策略, 该条 cookie 不会生效. ```js res.cookie("domain", "domian", { domain: "yanceyleo.com" }); ``` #### expires / maxAge 这两个属性都是设置 cookie 的 `过期时间`. 不同的是, `expires` 接收一个 Date 格式的时间, 而 `maxAge` 接收一个 `毫秒时间戳`. 因为后者更加直观和简便, 所以建议使用 `maxAge`. 两个属性都可以传递一个 `负值` 或者 `0`, 如果浏览器已存在同名 cookie, 则会清除此 cookie, 否则该条 cookie 不会被创建. 下面这个例子是创建一条 cookie, 并将该 cookie 的过期时间设为一天后. ```js res.cookie("expires", "expires", { expires: new Date(Date.now() + 24 * 60 * 60 * 1000), }); ```  接着给该条 cookie 设置一个 **负数**, 那么这条 cookie 就被清除了. ```js res.cookie("expires", "expires", { expires: new Date(Date.now() - 8 * 60 * 60 * 1000), }); ``` maxAge 的用法同理, 它直接传递一个 `过期时间` 的毫秒数即可. 下面的例子是将该条 cookie 的过期时间设为 7 天后. ```js res.cookie("maxAge", "maxAge", { maxAge: 7 * 24 * 60 * 60 * 1000, }); ``` 那么不设置过期时间的 cookie 会怎样呢? 当你关闭该网站的时候, 这些没有被设置过期时间的 cookie 就死翘翘了 (这种情况的 cookie 就好像是 session). #### httpOnly 当该属性设为 true 时, `document.cookie` 将无法获取该条 cookie, 但服务端可以照常获得. 该属性可以有效的避免跨站脚本攻击 (XSS). 关于网络安全方面的话题, 后面会专门写一篇文章去讲. ```js res.cookie("httpOnly", "httpOnly", { // 只能被 web server 访问到, 也就是说在浏览器输入 document.cookie 无法取到该条 cookie, 目的是防止 xss httpOnly: true, }); ``` #### path 该属性给 `指定的路径` 添加此 cookie, 默认为 `/`. 如下代码就是给 `users` 这个路由设置 cookie (即便在服务端该路径不存在也会被添加上). ```js res.cookie("path", "path", { path: "/users", }); ```  #### secure 只有当连接是 HTTPS 协议, 该 cookie 才会被添加. 该属性默认为 fasle. 因为我本地的 express 是 HTTP 协议, 因此该条 cookie 不会生效. ```js res.cookie("secure", "secure", { secure: true, }); ``` #### signed (防篡改签名) 该属性是给浏览器发送一个加密的 cookie, 该属性默认为 false. 在 express 中, 我们可以使用 `cookie-parser` 插件来创建一个加密后的 cookie. 服务端通过该 cookie 的内容和签名来检验它是否 `被篡改` 首先给 `cookieParser` 传入一个 secret. ```js app.use(cookieParser("forcabarca")); ``` 然后返回一个 sign 后的 cookie. ```js res.cookie("signed", "signed", { signed: true, }); ```  在 express 中, 我们可以使用 `req.cookies` 来获得 `未加密` 的 cookie 对象, 可以通过 `req.signedCookies` 来获得 `已加密` 的 cookie 对象. ```js console.log(req.cookies); // { httpOnly: 'httpOnly' } console.log(req.signedCookies); // { signed: 'signed' } ``` #### sameSite 它允许您声明该 Cookie 是否仅限于第一方或者同一站点上下文. SameSite 接受下面三个值: * **Lax**: Cookies 允许与顶级导航一起发送, 并将与第三方网站发起的 GET 请求一起发送. 这是浏览器中的默认值. * **Strict**: Cookies 只会在第一方上下文中发送, 不会与第三方网站发起的请求一起发送. * **None**: Cookie 将在所有上下文中发送, 即允许跨域发送. ### cookie 的缺点 Cookie 上限只有 4kb; 同一个域名下的所有请求, 都会携带 Cookie, 这意味着大量不需要 Cookie 传输的 HTTP 请求都被迫携带 Cookie, 造成极大的性能浪费. ### document.cookie 字符串转对象的函数 关于 cookie 就说这么多, 最后附赠一个 `document.cookie` 字符串转对象的函数, 如果你有更好的实现方式, 请在下面留言. ```js const parseCookie = (str) => str.split(";").reduce((cookies, cookie) => { const [name, value] = cookie.split("=").map((c) => c.trim()); cookies[name] = decodeURIComponent(value); return cookies; }, {}); ``` ## Session session 是服务端使用的一种记录客户端状态的机制, 与 cookie 不同的是, session 保存在 服务端. 当客户端初次发送请求时 (比如登录成功), 服务端会将用户信息以某种形式保存在服务端, 当再次访问时只需从该 session 中找到该客户的状态即可. 因此, cookie 机制就是通过检查客户身上的 **通行证** 来确定客户身份, 而 session 则是通过检查服务器上的 **客户明细表** 来确认客户身份. session 相当于程序在服务器上建立的一份客户档案, 客户来访的时候只需要查询客户档案表就可以了. 因为 HTTP 是无状态的, 所以单纯的 session 仍不能判断是否为到底是哪个用户. 因此服务端仍要向客户端发送一个 maxAge 为 `-1` 的 cookie 来作为不同用户的唯一标识. 当然你也可以不使用 cookie, 你可以通过重写 URL 地址的方式来实现. 它的原理是将用户的 seesion id 写入到 URL 中, 当浏览器解析新的 URL 时就可以定位到是哪位用户. 万变不离其宗, 两种方式都是要保证用户信息以某种形式保存到客户端. 更先进的 localStorage, sessionStorage, IndexedDB 也是同样的道理, 这里不去细说. ## HTTP 报文 用于 HTTP 协议交互的信息被称为 HTTP 报文. 客户端的报文叫做请求报文, 服务端的报文叫做响应报文. HTTP 报文本身是有多行数据构成的字符串文本. ### 报文格式 报文格式由下面四个部分组成: * 起始行(start line): 描述请求或响应的基本信息(有请求行和状态行两种); * 头部字段集合(header): 使用 key-value 形式更详细地说明报文; * 空行: 也叫 CRLF, 十六进制的 0D0A. * 消息正文(entity): 实际传输的数据, 它不一定是纯文本, 可以是图片, 视频等二进制数据. 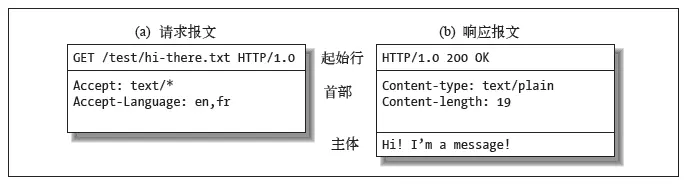 ### 请求行和状态行 起始行分为两种, 分别是请求行和状态行. 对于起始行, 如果是来自 Request, 叫做请求行; 如果来自 Response, 就做状态行(并不叫做响应行). 请求行有三部分构成: 1. 请求方法: 是一个动词, 如 GET/POST, 表示对资源的操作; 2. 请求目标: 通常是一个 URI, 标记了请求方法要操作的资源; 3. 版本号: 表示报文使用的 HTTP 协议版本. ```ts GET / HTTP / 1.1; ``` 状态行有三部分构成: 1. 版本号: 表示报文使用的 HTTP 协议版本; 2. 状态码: 一个三位数, 用代码的形式表示处理的结果, 比如 200 是成功, 500 是服务器错误; 3. 原因: 作为数字状态码补充, 是更详细的解释文字, 帮助人理解原因. ### 压缩报文 HTTP 协议中有一种被称为 `内容编码` 的功能, 可以有效的压缩报文的体积. 内容编码指明应用在实体内容上的编码格式, 并保持实体信息原样压缩. 内容编码后的实体由客户端接收并负责解码. 常见的内容编码有以下几种: * identity (不做压缩) * compress (UNIX 系统的标准压缩) * gzip (GNU zip, 最常见, 对文本压缩率较高, 对图片, 音视频等二进制数据压缩率较低, 甚至会变大) * deflate (zlib) * brotli (Google 出品, 必属精品. 比 gzip 的压缩率还要高 37%+, 我的网站已使用 brotli, 看下图) 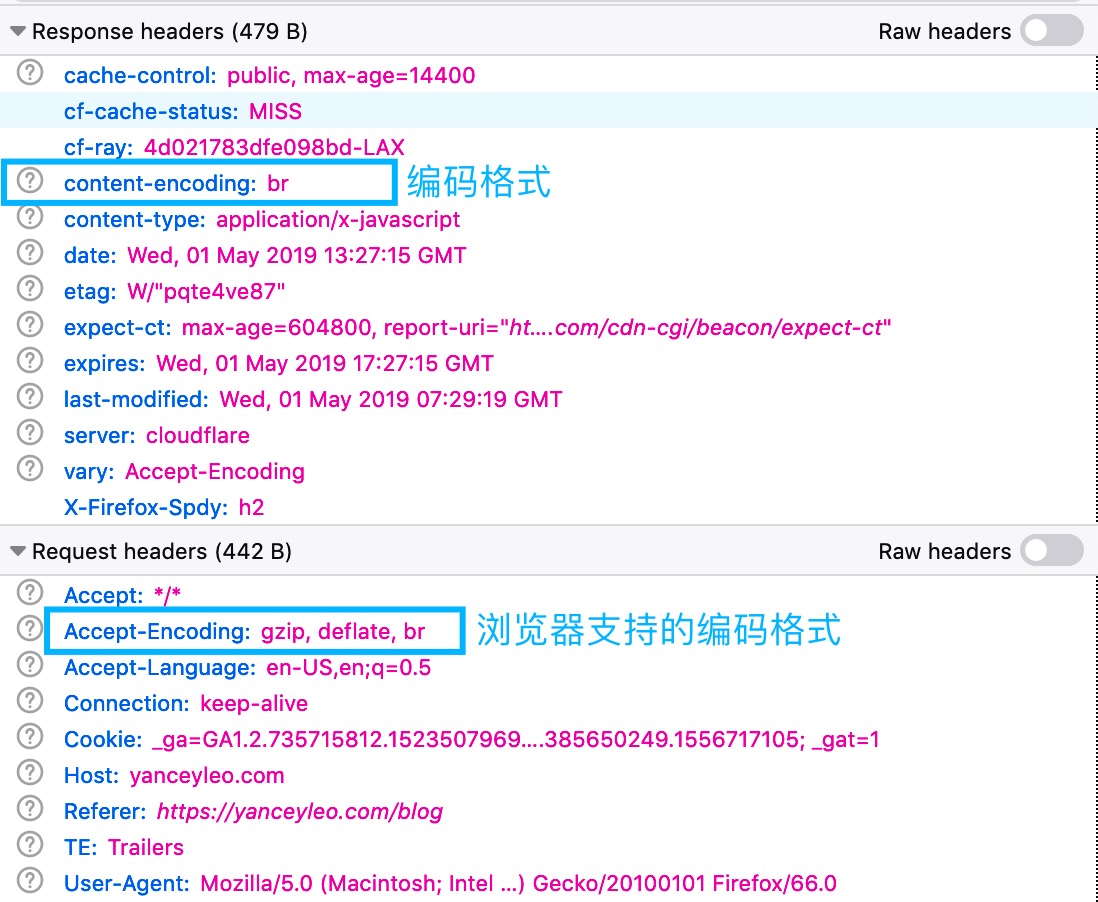 ### 分割发送的分块传输编码 从 HTTP 请求回来, 就产生了流式的数据, 后续的 DOM 树构建, CSS 计算, 渲染, 合成, 绘制, 都是尽可能地流式处理前一步的产出: 即不需要等到上一步骤完全结束, 就开始处理上一步的输出, 这样我们在浏览网页时, 才会看到逐步出现的页面. 本质上来说, 在 HTTP 通信过程中, 请求的编码实体资源尚未全部传输完成之前, 浏览器无法显示请求页面. 在传输大容量数据时, 通过把数据分割成多块, 能让浏览器逐步显示页面. 这种把实体主体分块的功能称为分块传输编码 (Chunked Transfer Code). 分块传输编码会将实体主体分为多个块, 每个块都会使用十六进制来标记大小, 而实体主体的最后一块会使用 `0 (CR+LF)` 来标记. 使用分块传输编码的实体主体会由接收的客户端负责解码, 恢复到编码前的实体主体. ## HTTP 报文首部 对于请求报文, 它的首部由方法, URL, HTTP 版本, HTTP 首部字段等部分构成. 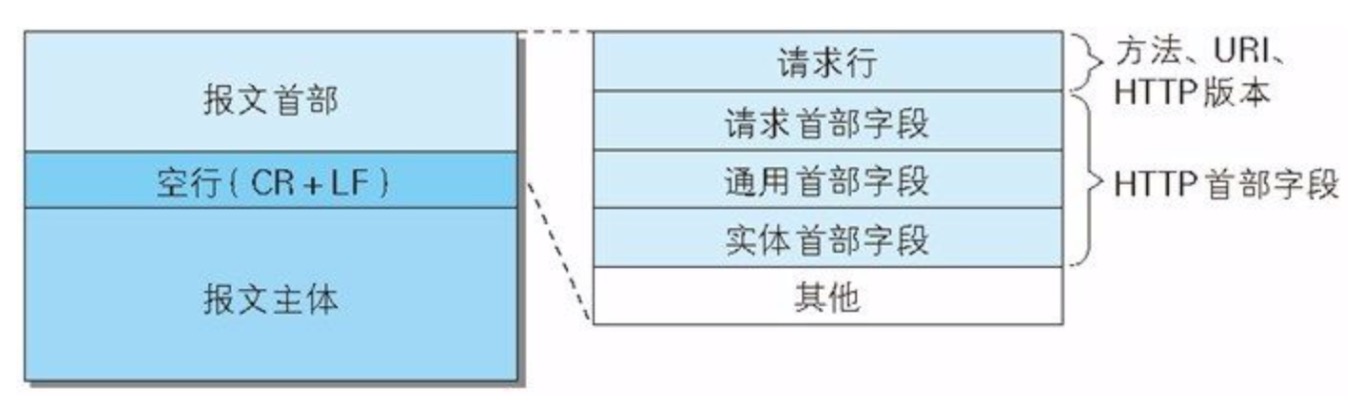 对于响应报文, 它的首部分别由 HTTP 版本, 状态码, HTTP 首部字段等部分构成.  ### 首部字段类型 * **通用首部字段 (General Header Field)** 请求报文和响应报文两方都会使用的首部. * **请求首部字段 (Request Header Field)** 从客户端向服务端发送请求报文时使用的首部. 补充了请求的附加内容, 客户端信息, 响应内容相关优先级等信息. * **响应首部字段 (Response Header Field)** 从服务端向客户端返回响应报文时使用的首部. 补充了响应的附加内容, 也会要求客户端附加额外的内容信息. * **实体首部字段 (Entity Header Field)** 针对请求报文和响应报文的实体部分使用的首部. 补充了资源内容更新时间等与实体有关的信息. ### End-to-end 首部 和 Hop-by-hop 首部 HTTP 首部字段将定义成缓存代理和非缓存代理的行为, 分成 `端到端首部` 和 `逐条首部`. 分到 `端到端首部` 的首部会转发给请求/响应对应的最终接收目标, 且必须保存在由缓存生成的响应中, 并且它必须被转发. 分到 `逐跳首部` 的首部只对单次转发有效, 会因通过缓存或代理而不再转发. 在 HTTP/1.1 之后的版本, 如果使用逐跳首部, 则需要提供 Connection 首部字段. 其中 Connection, Keep-Alive, Proxy-Authenticate, , Proxy-Authorization, Trailer, TE, Transfer-Encoding, Upgrade 这 8 个为逐跳首部, 其余都为端到端首部. ### 通用首部字段 #### Cache-Control 该字段用于控制缓存的工作机制, 它接受多个参数, 中间用逗号隔开. | 指令 | 参数 | 类型 | 说明 | | ---------------- | ----------- | ---------- | ---------------------------------------------------------------- | | no-cache | 无 | 请求/响应都有该字段 | 若请求中包含该字段, 则表示客户端不接受缓存; 若服务端包含该字段, 缓存前必须先确认其有效性 | | no-store | 无 | 请求/响应都有该字段 | 不缓存请求或相应的任何内容. no-cache 响应实际上是可以存储到本地缓存区中的, 而 no-store 才是本地彻底不缓存 | | max-age | 单位为秒, 必需 | 请求/响应都有该字段 | 当缓存时间小于该值时, 客户端接受缓存的资源, 否则请求源服务器, 该指令的优先级高于 Expires | | max-state | 单位为秒, 可省略参数 | 只有请求拥有该字段 | 只要有该字段, 客户端就可以接受过期的缓存 | | min-fresh | 单位为秒, 必需 | 只有请求拥有该字段 | 该指令要求缓存服务器返回至少还未过指定时间的缓存资源 | | no-transform | 无 | 请求/响应都有该字段 | 无论在请求还是响应中, 都不允许缓存改变实体主体的媒体类型 | | only-if-cached | 无 | 只有请求拥有该字段 | 表示客户端仅在缓存服务器本地缓存目标资源的情况下才会要求去返回 | | cache-extension | - | 请求/响应都有该字段 | 新指令扩展 | | public | 无 | 只有响应拥有该字段 | 可向任意客户端提供相应的缓存 | | private | 可省略 | 只有响应拥有该字段 | 仅向特定用户返回响应 | | must-revalidate | 无 | 只有响应拥有该字段 | 可缓存, 但必须再向源服务器进行一次验证 | | proxy-revalidate | 无 | 只有响应拥有该字段 | 要求中间缓存服务器对缓存的响应有效性再进行确认 | | s-maxage | 单位为秒, 必需 | 只有响应拥有该字段 | 与 max-age 相比, 该指令仅适用于公共服务器 | #### Connection Connection 用于控制不再转发给代理的首部字段, 还可以管理持久连接. HTTP/1.1 默认是持久连接, 当服务端明确表示断开连接时, 则将 Connection 设为 Close. #### Date Date 表示创建报文的日期和时间, 它的格式如下. ```shell date: Sun, 05 May 2019 02:05:37 GMT ``` #### Trailer 该字段会事先说明在报文主体后记录了哪些首部字段, 可应用于 HTTP/1.1 分块传输编码. #### Transfer-Encoding 用于分块传输编码, 即在响应报文里用头字段 `Transfer-Encoding: chunked` 来表示, `Transfer-Encoding: chunked` 和 `Content-Length` 这两个字段是互斥的, 也就是说响应报文里这两个字段不能同时出现, 一个响应报文的传输要么是长度已知, 要么是长度未知的. 1. 每个分块包含两个部分, 长度头和数据块; 2. 长度头是以 CRLF(回车换行, 即 `\r `)结尾的一行明文, 用 16 进制数字表示长度; 3. 数据块紧跟在长度头后, 最后也用 CRLF 结尾, 但数据不包含 CRLF; 4. 最后用一个长度为 0 的块表示结束, 即 `0\r \r `; 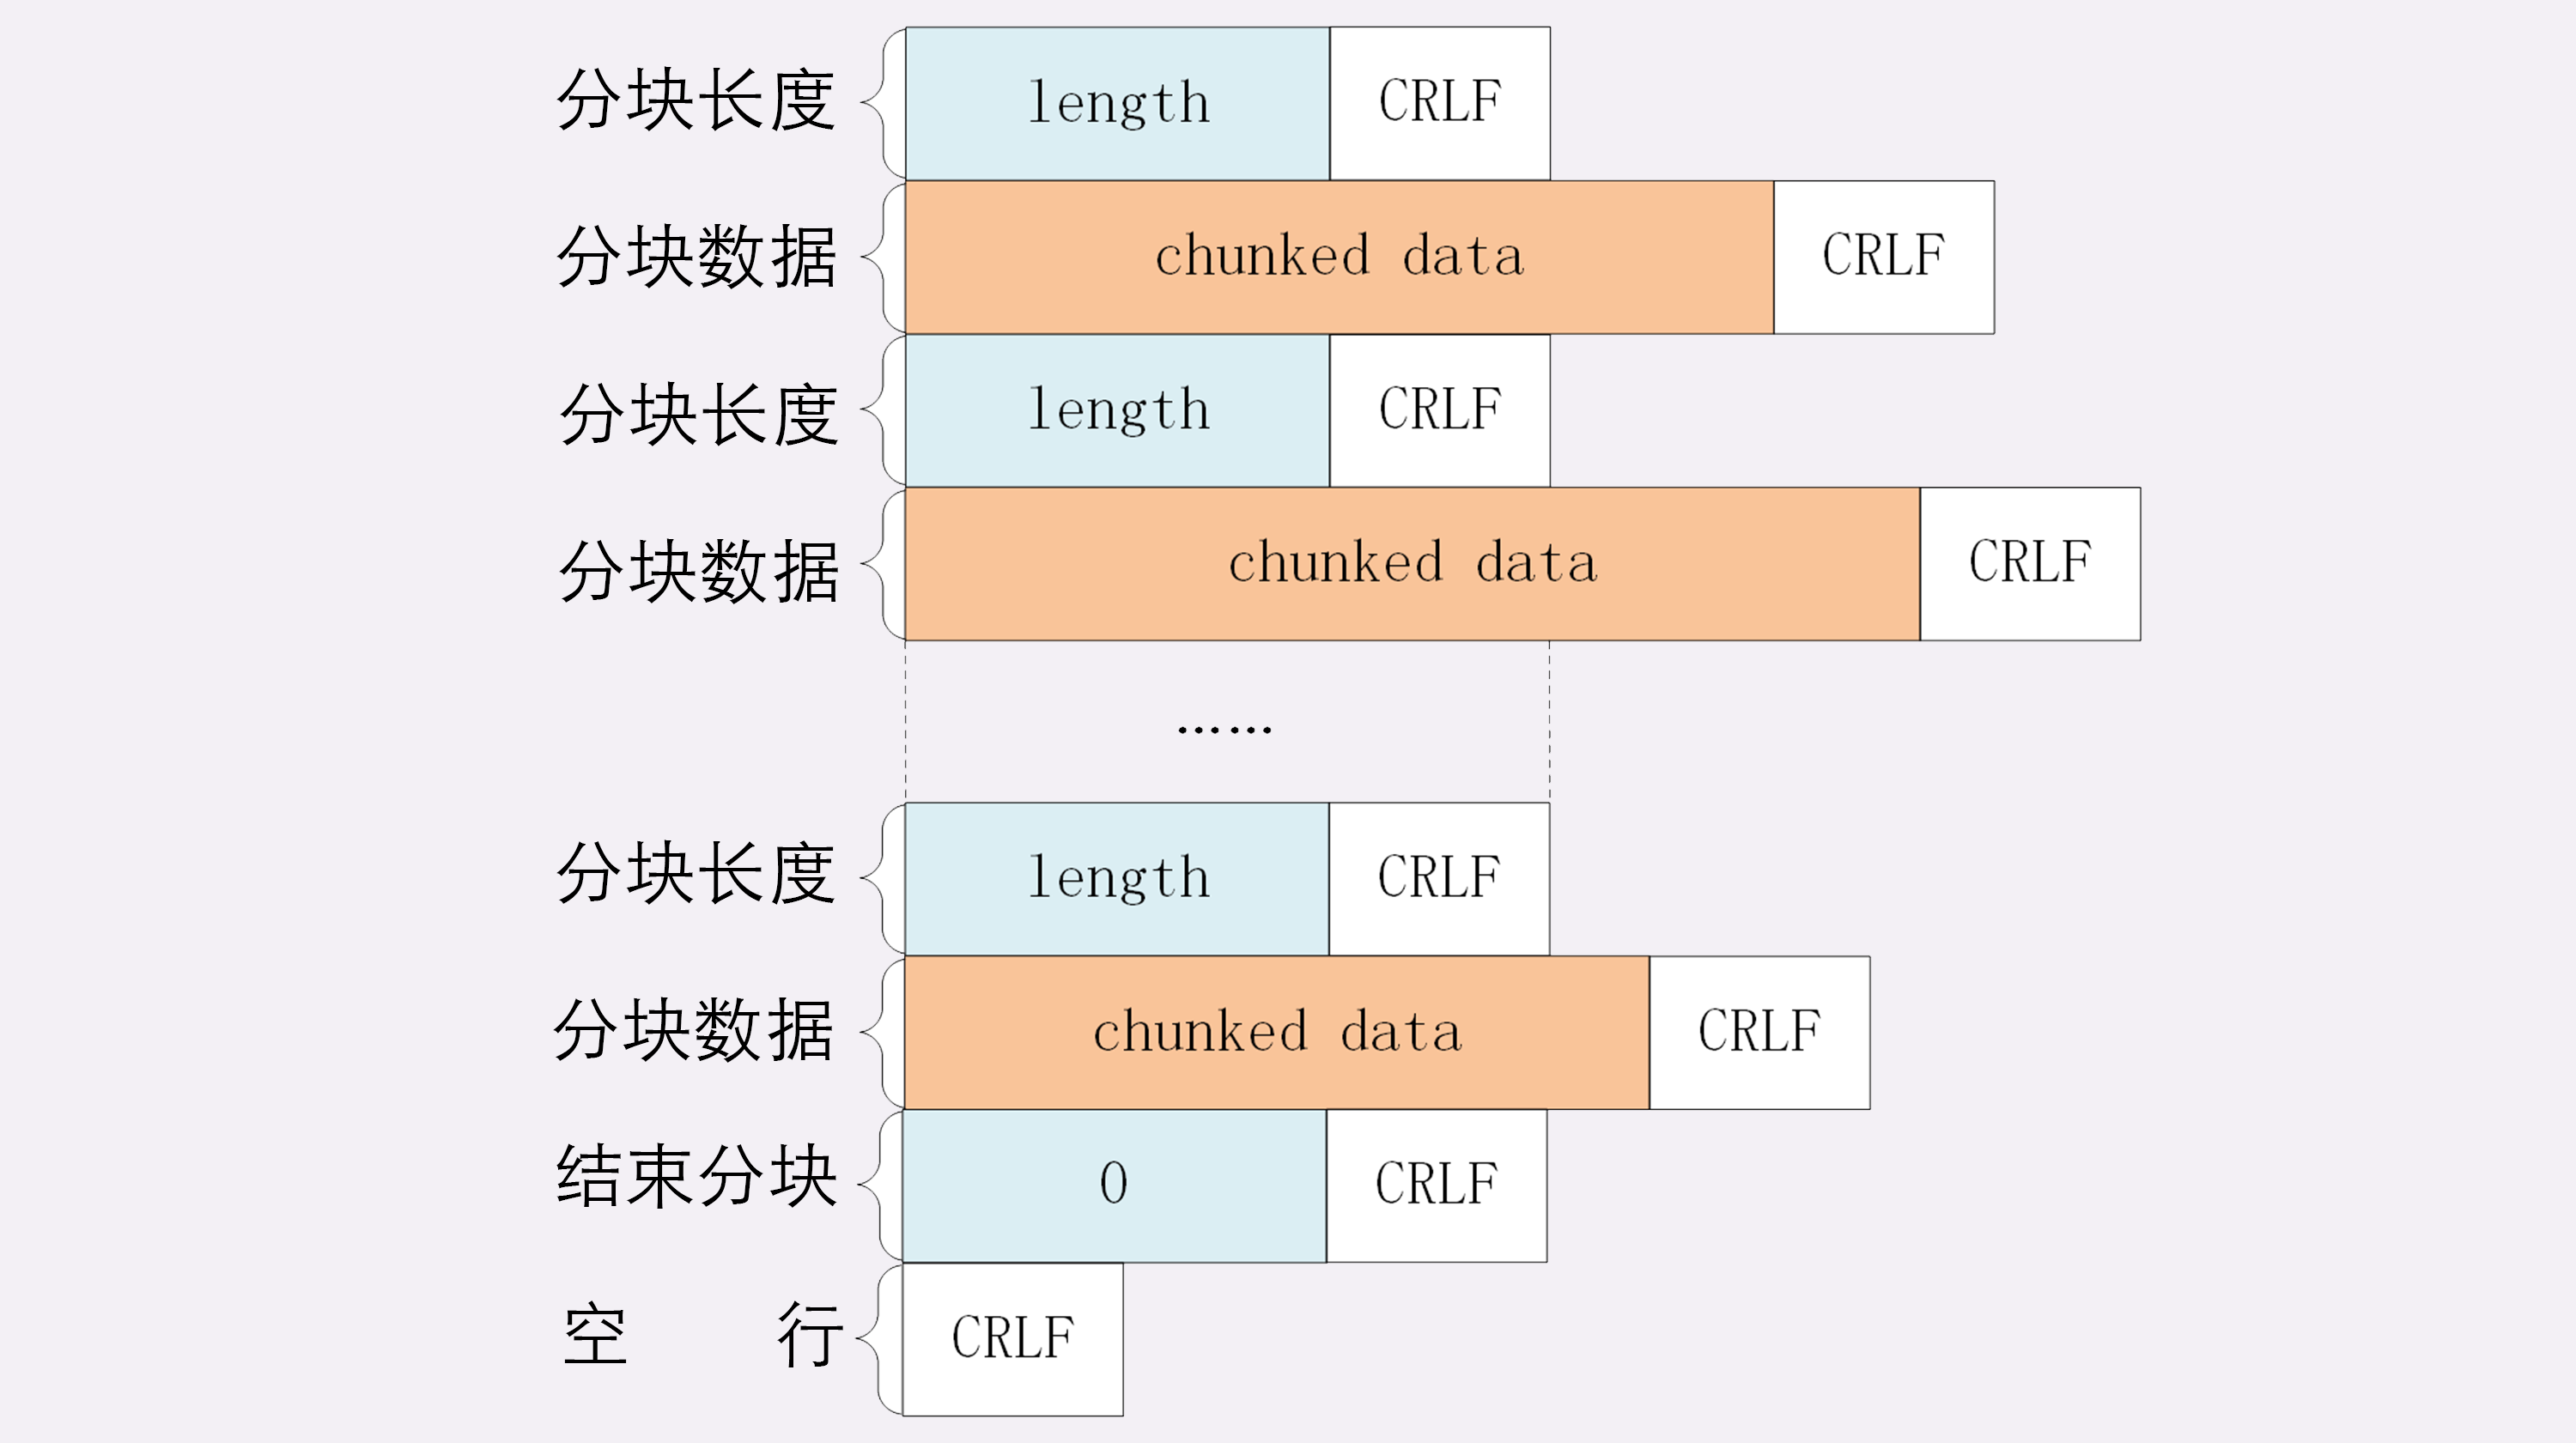 #### Upgrade 该字段用于检测 HTTP 协议或者其他协议是否可以使用更高的版本通信, 该字段要和 Connection 字段一起使用. 下面的例子是询问是否可以使用 TLS/1.0 协议. 对于附有 Upgrade 字段的请求, 服务端可返回 101 的状态码. ```shell connection: upgrade upgrade: TLS/1.0 ``` #### Via(后面还会详细讲) 该字段用于追踪客户端与服务器之间请求和响应报文的传输路径. ### 请求首部字段 #### Accept 该字段通知服务器, 用户代理能够处理的媒体类型及媒体类型的相对优先级, 或者说叫做内容协商, 即客户端用 Accept 头告诉服务器希望接收什么样的数据, 而服务器用 Content 头告诉客户端实际发送了什么样的数据. 其中用 q 表示权重. 下面的例子表示客户端可以接受纯文本类型或者 HTML, 以及两种图片类型, 并且接收纯文本类型的意愿 (权重)为 0.3. 相应的, 服务器会在响应报文里用头字段 Content-Type 告诉实体数据的真实类型. ```shell Accept: text/plain; q=0.3, text/html, image/webp, image/png ``` 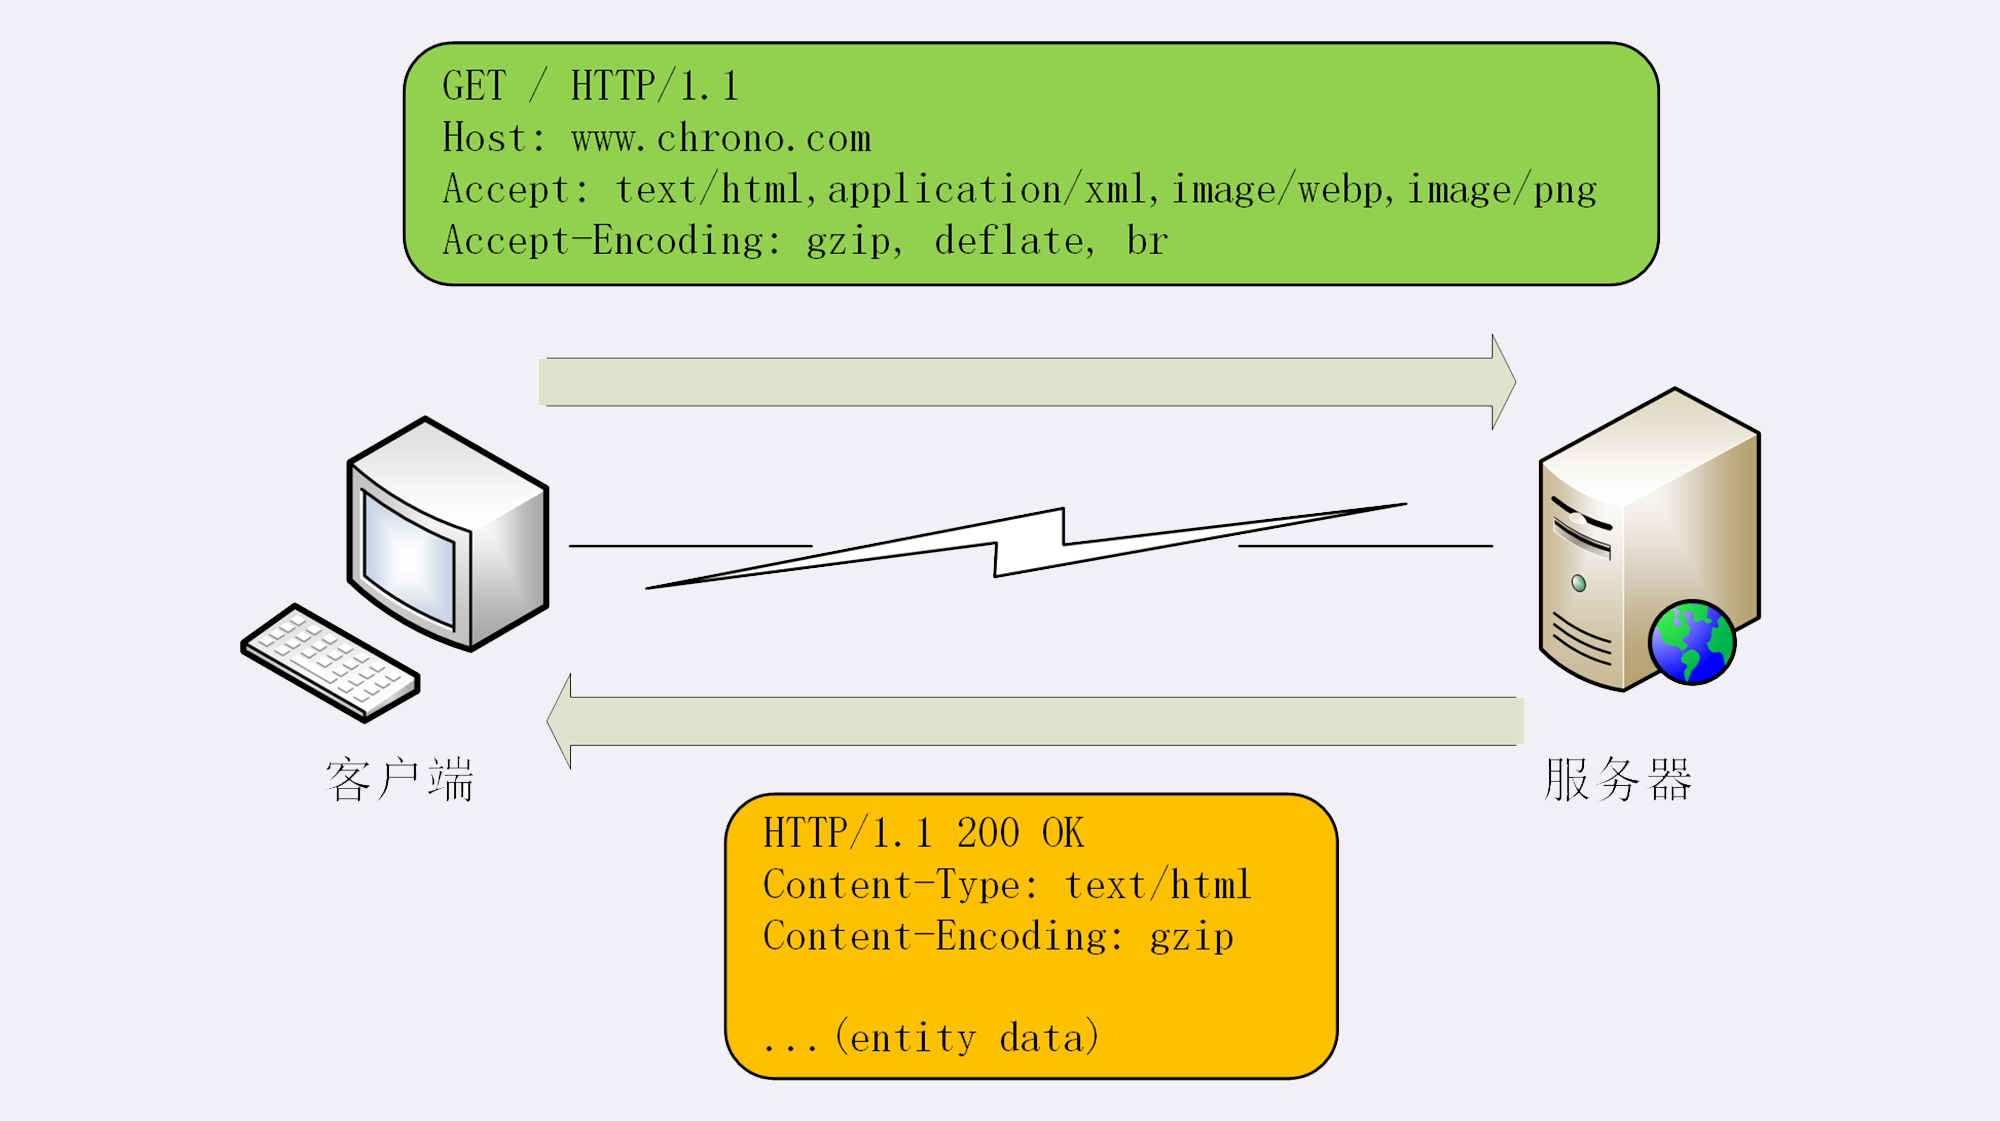 #### Accept-Charset 该字段通知服务器, 用户代理支持的字符集及字符集的相对优先级. 该字段应用于内容协商机制的服务器驱动协商. 如果服务器不能提供该字段的任何字符集, 会报 406 错误, 因此尽量不去使用该字段 (我试验了几个网站, 都没有此字段). 下面的例子表示客户端支持 utf-8 和 iso-8859-1, 且优先使用 utf-8. ```shell Accept-Charset: utf-8, iso-8859-1;q=0.5 ``` #### Accept-Encoding 该字段告知服务端, 客户端可使用的头部压缩算法. 上面 `压缩报文` 已经介绍了几种压缩方式, 这里不在赘述. ```shell Accept-Encoding: gzip, deflate, br ``` #### Authorization 该字段用于告知服务器, 用户代理的认证信息. 下面是我博客后台管理系统的一个场景, 在请求一个需要认证的接口时, 需要在请求头上附带认证信息. ```shell Authorization: Bearer JWT_TOKEN ``` #### Expect 客户端使用 Expect 来告知服务器, 期望出现的某种特定行为. 当服务器无法理解客户端的期望而发生错误时, 会返回 417 状态码. 该字段跟状态码 100 息息相关, 等待状态码 100 响应的客户端在发生请求时, 需要指定 `Expext: 100-continue`. 该状态码的用途主要是允许客户端发送带请求体的请求前, 判断服务器是否愿意接收请求. ```shell Expect: 100-continue ``` #### From 该字段用来告知服务器使用用户代理的用户的 Email. #### Host 当以单台服务器分配多个域名的虚拟主机时, Host 字段就可以用来确定相应的主机. 它属于请求字段, 只能出现在请求头里, 它同时也是唯一一个 HTTP/1.1 规范里要求必须出现的字段. ```shell Host: www.abc.com ``` #### If-Match 形如 `If-xxx` 的请求字段都可称为条件请求. 服务器在收到该类请求后, 只有判断条件为真时才会执行请求. 服务器会比对 If-Match 的字段值和资源的 ETag 值, 仅当两者一致时, 才会执行请求, 否则返回 412 状态码. 当 If-Match 的字段值为 `*` 时, 服务器会忽略 ETag 值, 只要资源存在就处理请求. ```shell If-Match: W/"pqxe5g29m4" ``` #### If-None-Match 与 If-Match 相反, 服务器会比对 If-None-Match 的字段值和资源的 ETag 值, 仅当两者 `不一致` 时, 才会执行请求. 在 GET 和 HEAD 方法中使用该字段会获取最新资源. #### If-Modified-Since 如果在 If-Modified-Since 字段指定的日期时间后, 资源发生了更新, 服务器会接受请求. 如果资源没更新过, 则返回 304 状态码. 该字段值和响应首部字段的 Last-Modifie 字段做比较, 下面的例子中显然最后修改时间要新于 If-Modified-Since 的时间, 因此会响应新的资源. ```shell // 请求首部字段 If-Modified-Since: Fri, 01 May 2019 11:20:04 GMT // 响应首部字段 Last-Modified: Fri, 03 May 2019 11:20:04 GMT ``` #### If-Unmodified-Since 如果在 If-Modified-Since 字段指定的日期时间后, 资源 `未发生` 更新, 服务器才会接受请求. 如果资源在此之后发生了更新, 则报 412 错误. #### If-Range 该字段值跟 相应头中的 ETag 或 Date 进行比较, 若一致, 就作为范围请求处理, 并返回状态码 206, 否则直接返回全部资源. #### Range 对于只需获取部分资源的范围请求, 包含首部字段 Range 即可告知服务器资源的指定范围. 接收到附带 Range 字段的请求的服务器, 会在处理请求之后返回状态码为 206 的响应. 当无法处理该范围请求时, 返回 200 状态码及全部资源. 请求头 Range 是 HTTP 范围请求的专用字段, 格式是**bytes=x-y**, 其中的 x 和 y 是以字节为单位的数据范围. x, y 表示的是**偏移量**, 如**0-10**实际上是前 11 个字节. Range 的格式也很灵活, 起点 x 和终点 y 可以省略, 能够很方便地表示正数或者倒数的范围. 假设文件是 100 个字节, 那么: * **0-表示从文档起点到文档终点, 相当于0-99**, 即整个文件; * **10-是从第 10 个字节开始到文档末尾, 相当于10-99**; * **-1**是文档的最后一个字节, 相当于**99-99**; * **-10**是从文档末尾倒数 10 个字节, 相当于**90-99**. 服务器收到 Range 字段后, 需要做四件事: 1. 查范围是否合法, 比如文件只有 100 个字节, 但请求 200-300, 这就是范围越界了, 返回 **416 Requested Range Not Satisfiable** 2. 如果范围正确, 服务器就可以根据 Range 头计算偏移量, 读取文件的片段了, 返回状态码 **206 Partial Content** 3. 服务器要添加一个响应头字段 Content-Range, 告诉片段的实际偏移量和资源的总大小, 格式为 **bytes x-y/z**, 其中 x 和 y 是片段的起点和终点, z 是资源的总大小. 4. 片段用 TCP 发给客户端 ```shell # 请求头 GET / HTTP/1.1 Host: www.yanceyleo.com Range: bytes=0-31 # 响应头 HTTP/1.1 206 Partial Content Content-Length: 32 Accept-Ranges: bytes Content-Range: bytes 0-31/96 ``` 不仅看视频的拖拽进度需要范围请求, 常用的下载工具里的多段下载, 断点续传也是基于它实现的, 要点是: * 先发个 HEAD, 看服务器是否支持范围请求, 同时获取文件的大小; * 开 N 个线程, 每个线程使用 Range 字段划分出各自负责下载的片段, 发请求传输数据; * 下载意外中断也不怕, 不必重头再来一遍, 只要根据上次的下载记录, 用 Range 请求剩下的那一部分就可以了. 范围不仅一次只获取一个片段, 其实它还支持在 Range 头里使用多个 **x-y**, 一次性获取多个片段数据. 这种情况需要使用一种特殊的 MIME 类型: **multipart/byteranges**, 表示报文的 body 是由多段字节序列组成的, 并且还要用一个参数 **boundary=xxx** 给出段之间的分隔标记. 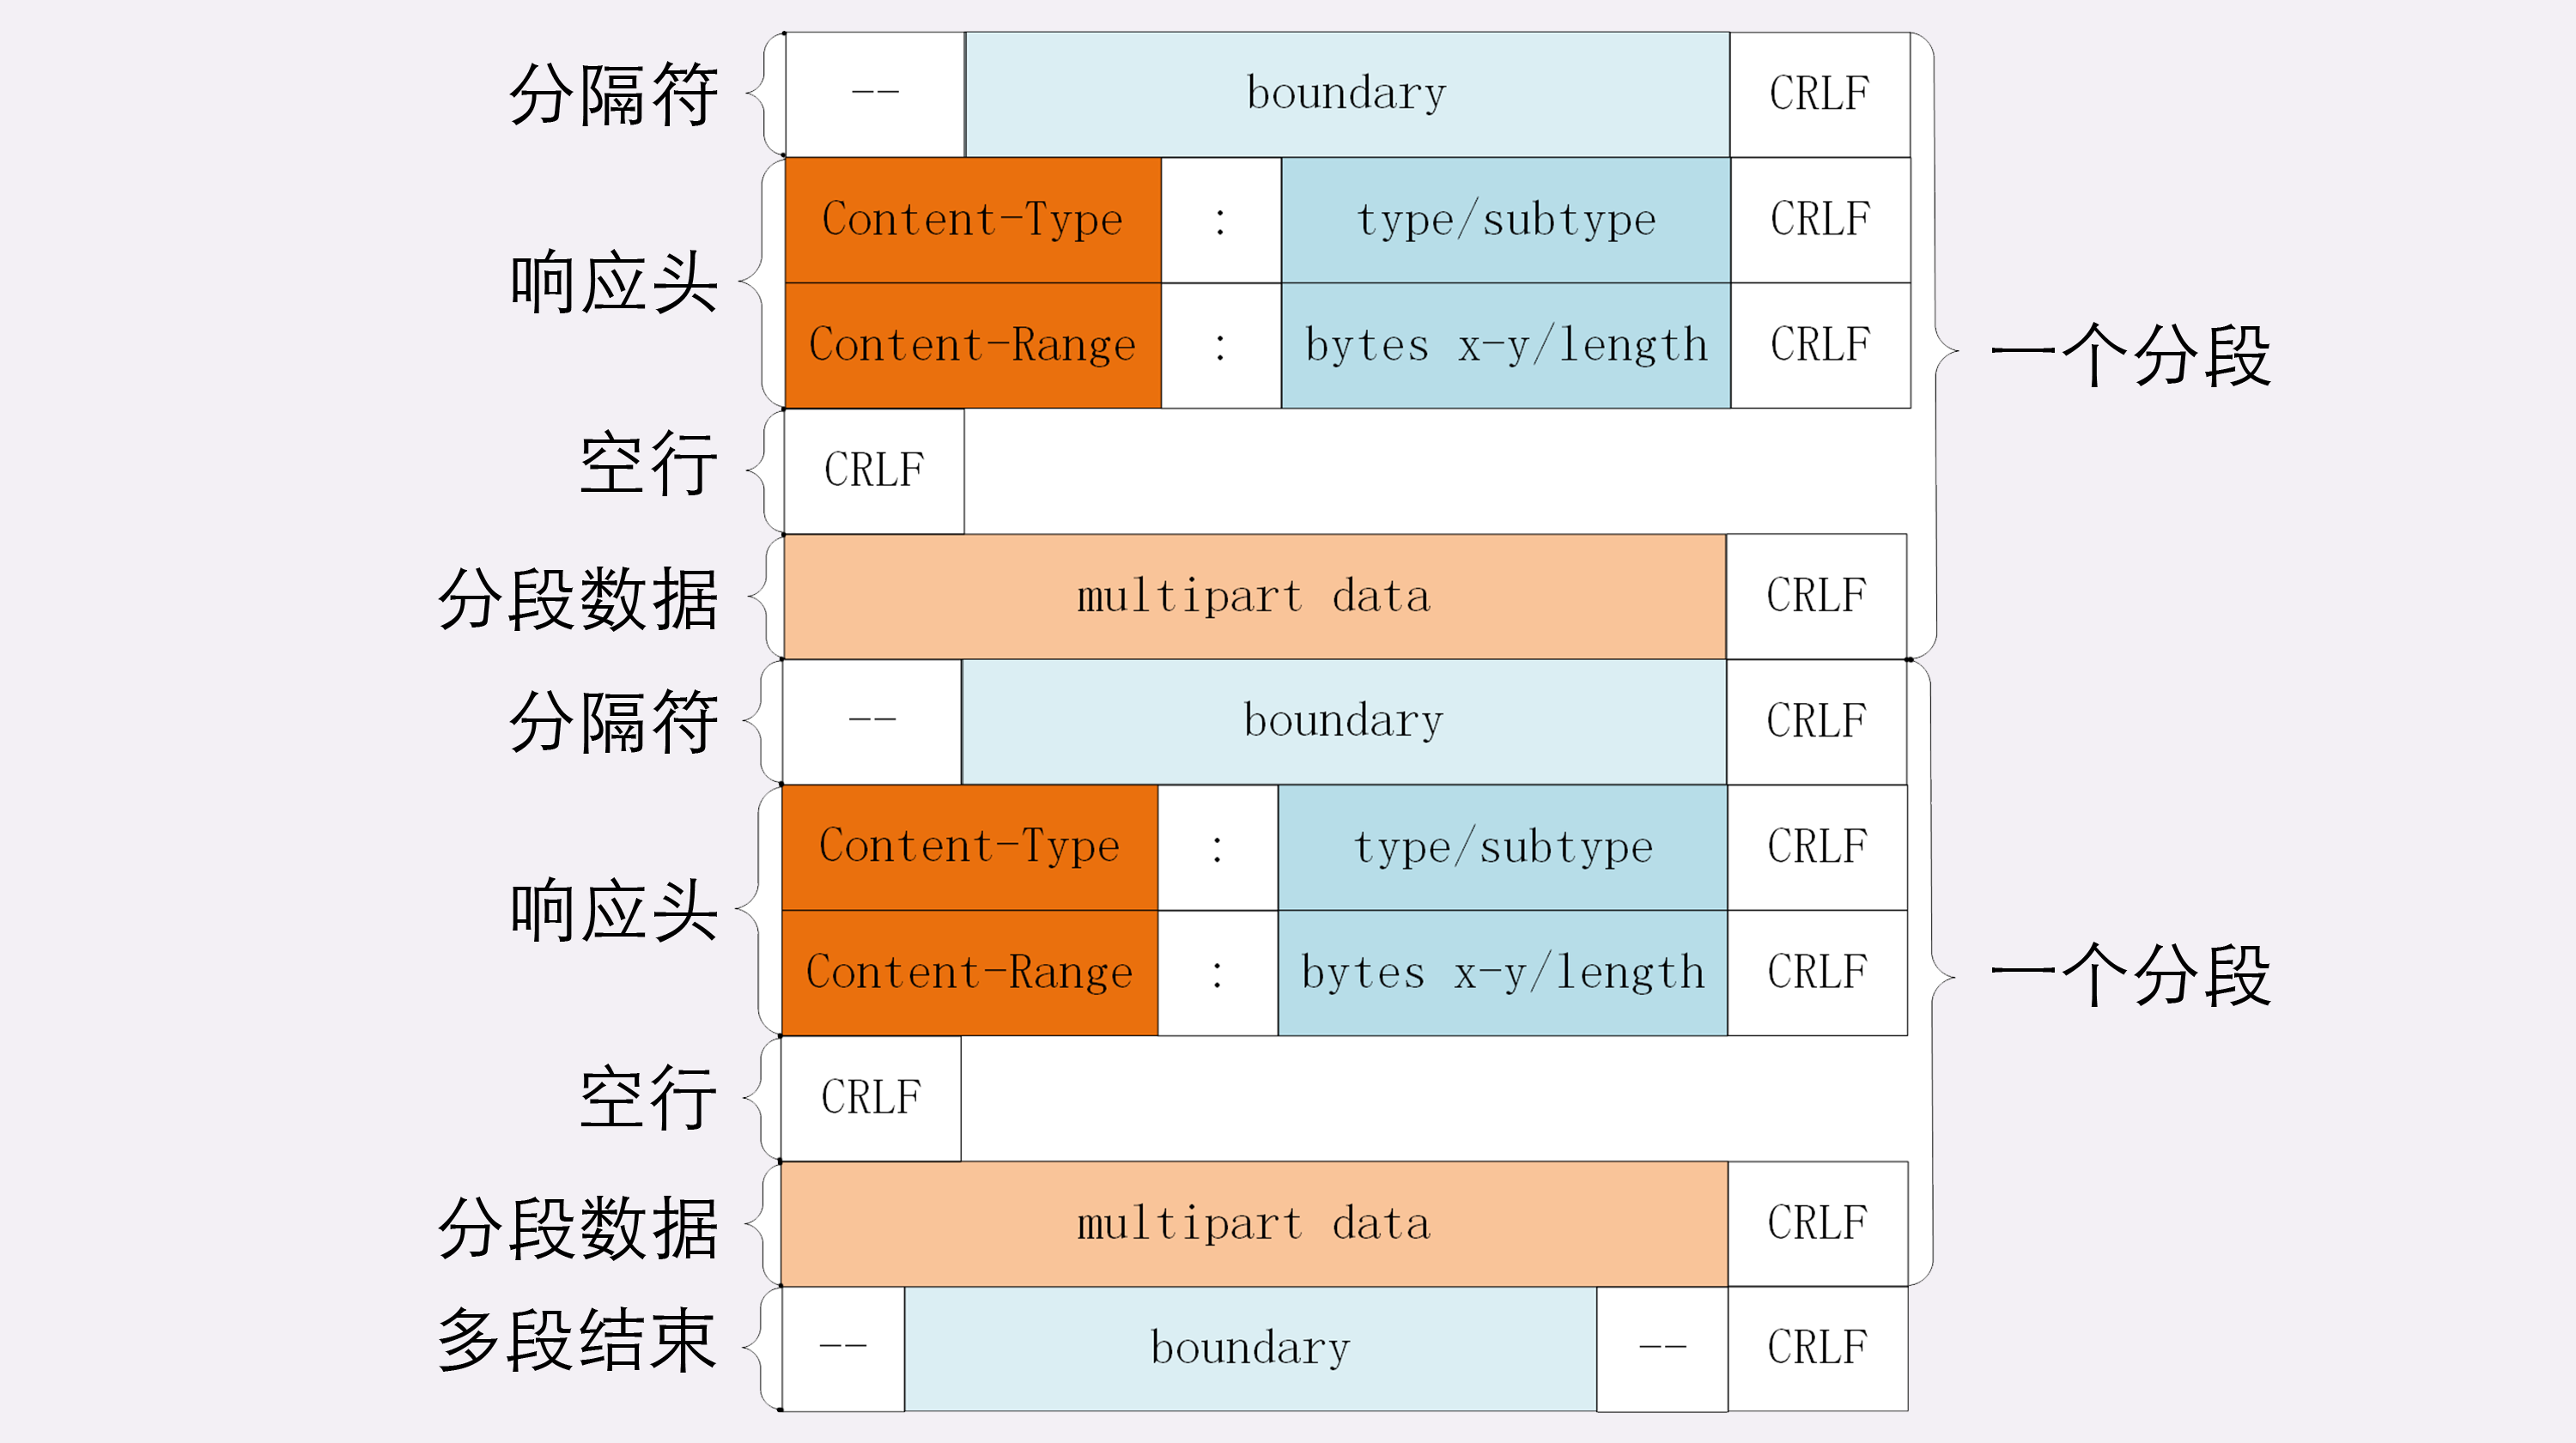 每一个分段必须以 **--boundary** 开始, 之后要用 **Content-Type** 和 **Content-Range** 标记这段数据的类型和所在范围, 然后就像普通的响应头一样以回车换行结束, 再加上分段数据, 最后用一个 **--boundary--** 表示所有的分段结束. ```shell # 请求头 GET /16-2 HTTP/1.1 Host: www.chrono.com Range: bytes=0-9, 20-29 # 响应头 HTTP/1.1 206 Partial Content Content-Type: multipart/byteranges; boundary=00000000001 Content-Length: 189 Connection: keep-alive Accept-Ranges: bytes --00000000001 Content-Type: text/plain Content-Range: bytes 0-9/96 --00000000001 Content-Type: text/plain Content-Range: bytes 20-29/96 --00000000001-- ``` #### Proxy-Authorization 该字段用于告知代理服务器, 用户代理的认证信息. #### Referer 告知服务器请求的 URI 是从哪儿发起的. 比如在我的博客 [www.yanceyleo.com](http://www.yanceyleo.com) 请求了 AliOSS 上的一张图片, 那么请求 AliOSS 服务器的那个请求头就会附上: ```shell Referer: https://www.yanceyleo.com ``` 当然该单词正确的拼写应该是 `referrer`, 但 `referer` 却沿用至今. 想起一句歌词: **在漫天风沙里, 望着你远去, 我竟悲伤的不能自己 (已).** #### TE 该字段会告知服务端, 客户端能够处理响应的传输编码方式及相对优先级. 它类似于 Accept-Encoding, 但用于传输编码. 除了指定传输编码, 还可以指定伴随 trailer 字段的分块传输编码方式. ```shell TE: gzip, delate;q=0.5 TE: trailers ``` #### User-Agent 这个字段再不认识直接回炉重造吧, 这里不去赘述, 直接看例子. ```shell User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.131 Safari/537.36 ``` ### 响应首部字段 #### Accept-Ranges 该字段用于告知客户端, 服务器是否能处理范围请求, 可处理时指定为 `bytes`, 否则为 `none`. 范围请求不是 Web 服务器必备的功能, 可以实现也可以不实现, 所以服务器必须在响应头里使用字段 **Accept-Ranges: bytes**, 明确告知客户端是支持范围请求的. 如果不支持的话, 服务器可以发送 **Accept-Ranges: none**, 或者干脆不发送 **Accept-Ranges**字段, 这样客户端就认为服务器没有实现范围请求功能, 只能老老实实地收发整块文件了. ```shell Accept-Ranges: bytes ``` #### Age 该字段用于告知客户端, 源服务器在多久前创建了响应, 字段值的单位为秒. 若创建该响应的服务器是缓存服务器, Age 值指的是缓存后的响应再次发起认证到认证完成的时间值 (CDN). ```shell Age: 500 ``` #### ETag ETag 是将资源以字符串的形式做唯一性标识, 服务器会为每份资源分配对应的 ETag 值. 当资源更新时, ETag 值也需要更新. ETag 有 `强 Etag 值` 和 `弱 Etag 值` 之分. 前者是指无论实体发生多么细微的变化都会改变其值. 而弱 ETag 只用于提示资源是否相同. 只有资源发生了根本变化, 产生差异时才会改变 ETag 值, 弱 ETag 字段值前面会有 `W` 标识. 前者就好比使用了 `{deep: true}` 一样. 下面的代码是一张图片的 ETag, 显然一张图片改变意味着资源的彻底改变, 因此使用了强 ETag. ```shell ETag: "F8F155B13C6DA43723EEDE3EDBBB4D28" ``` 下面的代码是请求一个数据接口的 ETag, 大多数情况不会发生根本性的改变, 因此使用弱 ETag. ```shell etag: W/"300af-7JrdwEcHHeXMqn/UCrMO0zsO0SY" ``` #### Location Location 字段标记了服务器要求重定向的 URI, 该字段一般会配合 3xx 的状态码使用. ```shell Location: https://yanceyleo.com ``` #### Proxy-Authenticate 该字段会把由代理服务器所要求的认证信息发送给客户端. #### Retry-After 该字段告知客户端应该在多久之后再次发送请求. 当服务器出错报 503 时, 如果服务端知道什么时候可以恢复, 那么就应该通过该字段告知客户端. 该字段的字段值可以是具体的日期时间, 也可以是创建响应后的秒数. ```shell Retry-After: Sat, 04 May 2019 11:26:52 GMT ``` #### Server 该字段也是一个常见字段, 用于告知客户端, Web 服务器的名称. 比如我使用了 cloudflare 的 CDN, 因此服务器如下所示. ```shell server: cloudflare ``` #### Vary 该字段可用于对缓存进行控制, 它的字段值接收一系列其他首部字段名. ```shell vary: Accept-Encoding,Cookie ``` 上面这个例子中, 源服务器向代理服务器发送了 vary 字段, 代理服务器若要进行缓存, 只能对 Accept-Encoding 和 Cookie 进行缓存. 以 **Vary: Accept-Encoding** 为例, 当一个资源启用了 gzip 压缩, 并且被代理服务器缓存, 客户端如果不支持 gzip 压缩, 那么在这样的情况下将会得到不正确的数据(也就是压缩过的数据). 这将会使代理服务器缓存两个版本的资源: 一个是压缩过的, 一个是没压缩过的. 正确版本的资源将在请求头发送之后进行传输. 此外, IE 浏览器不缓存任何带有 Vary 头但值不为 Accept-Encoding 和 User-Agent 的资源. 所以通过这种方式添加这个头, 才能确保这些资源在 IE 下被缓存. 同一个请求, 经过内容协商后可能会有不同的字符集, 编码, 浏览器等版本. 比如, **Vary: Accept-Encoding**, **Vary: User-Agent**, 缓存代理必须要存储这些不同的版本. 当再收到相同的请求时, 代理就读取缓存里的 **Vary**, 对比请求头里相应的 **Accept-Encoding**, **User-Agent** 等字段, 如果和上一个请求的完全匹配, 比如都是**gzip**, **Chrome**, 就表示版本一致, 可以返回缓存的数据. #### WWW-Authenticate 该字段告知客户端适用于访问请求 URI 所指定资源的认证方案和带参数提示的质询. ### 实体首部字段 #### Allow 该字段会告知客户端所支持的所有 HTTP 请求方法, 当服务端接收到不支持的 HTTP 方法时, 会返回 405 状态码, 并将所有能支持的 HTTP 方法写入首部字段. ```shell Allow: GET, PUT ``` #### Content-Encoding 告知客户端服务器使用的内容编码方式. ```shell content-encoding: br ``` #### Content-Language 告知客户端实体主体使用的自然语言. 与之配套的客户端请求头是 Accept-Language. ```shell content-language: zh-CN ``` #### Content-Length 该字段表明了实体主体部分的大小, 单位是字节. ```shell Content-Length: 4871261 ``` #### Content-MD5 该字段用于检查报文主体在传输过程中是否保持完整性, 以及确认传输到达. 服务端对报文主体执行 MD5 算法, 获取一个 128 位的二进制数, 再通过 base64 编码后将结果写入 Content-MD5 字段值. 因为 HTTP 首部无法记录二进制值, 因此需要通过 Base64 进行处理. 客户端在接收到响应后再对报文主体执行一次相同的 MD5 算法. 将计算值于该字段值比较, 即可判断出报文主体的准确性. ```shell Content-MD5: +PFVsTxtpDcj7t4+27tNKA== ``` #### Content-Range 该字段告知客户端作为响应返回的实体的哪个部分符合范围请求, 字段值以字节为单位. #### Content-Type 非常常见的字段, 用来说明实体主体内对象的媒体类型. ```shell content-type: application/json; charset=utf-8 ``` 这里多说一嘴 MIME. 我们知道 HTTP 的 body 可以传输非文本, 比如可以是图片, 视频等, 这些通过 MIME 来区分, 早在 HTTP 协议诞生之前就已经有了针对这种问题的解决方案, 不过它是用在电子邮件系统里的, 让电子邮件可以发送 ASCII 码以外的任意数据, 方案的名字叫做**多用途互联网邮件扩展**(Multipurpose Internet Mail Extensions), 简称为 MIME. 下面举几个例子: * text: 即文本格式的可读数据, 我们最熟悉的应该就是 text/html 了, 表示超文本文档, 此外还有纯文本 text/plain, 样式表 text/css 等. * image: 即图像文件, 有 image/gif, image/jpeg, image/png 等. * audio/video: 音频和视频数据, 例如 audio/mpeg, video/mp4 等. * application: 数据格式不固定, 可能是文本也可能是二进制, 必须由上层应用程序来解释. 常见的有 application/json, application/javascript, application/pdf 等, 另外, 如果实在是不知道数据是什么类型, 就会是 application/octet-stream, 即不透明的二进制数据. #### Expires 该字段将资源失败的日期告诉客户端, 在 Expires 指定的时间之前, 响应的副本会一直被保存. 当超过指定的时间后, 缓存服务器在请求发送过来时, 转向源服务器请求资源. 当首部字段 Cache-Control 有指定的 max-age 时, 会优先处理 max-age. 关于缓存机制下一章会详细去讲. #### Last-Modified 该字段指明资源的最终修改时间, 一般来讲, 该值就是 Request-URI 指定资源的被修改的时间. ### 头部字段的几个注意点 1. 字段名不区分大小写, 例如**Host**也可以写成**host**, 但首字母大写的可读性更好; 2. 字段名里不允许出现空格, 可以使用连字符 **-**, 但不能使用下划线 **_**. 例如, **test-name** 是合法的字段名, 而 **test name** 和 **test_name** 是不正确的字段名; 3. 字段名后面必须紧接着 **:**, 不能有空格, 而 **:** 后的字段值前可以有多个空格; 4. 字段的顺序是没有意义的, 可以任意排列不影响语义; 5. 字段原则上不能重复, 除非这个字段本身的语义允许, 例如 Set-Cookie. ## HTTP 方法 | 方法名 | 描述 | | ---------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | | GET | GET 请求会显示请求指定的资源. 一般来说 GET 方法应该只用于数据的读取, 而不应当用于会产生副作用的非幂等的操作中. 它期望的应该是而且应该是安全的和幂等的. 这里的安全指的是, 请求不会影响到资源的状态. 此外, GET 还可以搭配 URI 和其他头字段就能实现对资源更精细的操作. 比如搭配 # 可以用作锚点, 与 If-Modified-Since 字段就变成了**有条件的请求**, 仅当资源被修改时才会执行获取动作; 使用 Range 字段就是**范围请求**, 只获取资源的一部分数据 . | | HEAD | HEAD 方法与 GET 方法一样, 都是向服务器发出指定资源的请求. 但是, 服务器在响应 HEAD 请求时不会回传资源的响应主体, 而只返回头部. 这样, 我们可以不传输全部内容的情况下, 就可以获取服务器的响应头信息. HEAD 方法常被用于客户端查看服务器的性能. | | PUT | PUT 请求会身向指定资源位置上传其最新内容, PUT 方法是幂等的方法. 通过该方法客户端可以将指定资源的最新数据传送给服务器取代指定的资源的内容. | | POST | POST 请求会 向指定资源提交数据, 请求服务器进行处理, 如: 表单数据提交, 文件上传等, 请求数据会被包含在请求体中. POST 方法是非幂等的方法, 因为这个请求可能会创建新的资源或/和修改现有资源. | | TRACE | TRACE 请求服务器回显其收到的请求信息, 该方法主要用于 HTTP 请求的测试或诊断. | | OPTIONS | OPTIONS 请求与 HEAD 类似, 一般也是用于客户端查看服务器的性能. 这个方法会请求服务器返回该资源所支持的所有 HTTP 请求方法, 该方法会用'*'来代替资源名称, 向服务器发送 OPTIONS 请求, 可以测试服务器功能是否正常. JavaScript 的 XMLHttpRequest 对象进行 CORS 跨域资源共享时, 就是使用 OPTIONS 方法发送嗅探请求, 以判断是否有对指定资源的访问权限. | | DELETE | DELETE 请求用于请求服务器删除所请求 URI(统一资源标识符, Uniform Resource Identifier)所标识的资源. DELETE 请求后指定资源会被删除, DELETE 方法也是幂等的. | | PATCH | PATCH 方法出现的较晚, 它在 2010 年的 RFC 5789 标准中被定义. PATCH 请求与 PUT 请求类似, 同样用于资源的更新. 二者有以下两点不同: 1.PATCH 一般用于资源的部分更新, 而 PUT 一般用于资源的整体更新. 2.当资源不存在时, PATCH 会创建一个新的资源, 而 PUT 只会对已在资源进行更新. | | CONNECT | CONNECT 方法是 HTTP/1.1 协议预留的, 能够将连接改为管道方式的代理服务器. 通常用于 SSL 加密服务器的链接与非加密的 HTTP 代理服务器的通信. | GET, HEAD, PUT 和 DELETE 是幂等方法, 而 POST 不是幂等的. ### GET 和 POST 的区别 数据传输方式不同: GET 请求通过 URL 传输数据, 而 POST 的数据通过请求体传输. 安全性不同: POST 的数据因为在请求主体内, 所以有一定的安全性保证, 而 GET 的数据在 URL 中, 通过历史记录, 缓存很容易查到数据信息. 数据类型不同: GET 只允许 ASCII 字符, 而 POST 无限制 GET 无害: 刷新, 后退等浏览器操作 GET 请求是无害的, POST 可能重复提交表单 特性不同: GET 是安全(这里的安全是指只读特性, 就是使用这个方法不会引起服务器状态变化)且幂等(幂等的概念是指同一个请求方法执行多次和仅执行一次的效果完全相同), 而 POST 是非安全非幂等 其他: GET 和 POST 本质上就是 TCP 链接, 并无差别. 但是由于 HTTP 的规定和浏览器/服务器 的限制, 导致他们在应用过程中体现出一些不同. GET 产生一个 TCP 数据包;POST 产生两个 TCP 数据包. ### 请求方法的安全与幂等 在 HTTP 协议里, 所谓的**安全**是指请求方法不会**破坏**服务器上的资源, 即不会对服务器上的资源造成实质的修改.所谓的**幂等**实际上是一个数学用语, 被借用到了 HTTP 协议里, 意思是多次执行相同的操作, 结果也都是相同的, 即多次**幂**后结果**相等**. GET 和 HEAD 既是安全的也是幂等的, DELETE 可以多次删除同一个资源, 效果都是**资源不存在**, 所以也是幂等的. POST 是**新增或提交数据**, 多次提交数据会创建多个资源, 所以不是幂等的; 而 PUT 是**替换或更新数据**, 多次更新一个资源, 资源还是会第一次更新的状态, 所以是幂等的. ## HTTP 状态码 HTTP 状态码负责表示客户端 HTTP 请求的返回结果, 标记服务器端的处理是否正常, 通知出现的错误等工作. ### 1xx 信息类状态码 | 状态码 | 状态码英文名称 | 描述 | | ---------- | ------------------- | --------------------- | | 100 | Continue | 服务器收到请求的初始部分, 请客户端继续. | | 101 | Switching Protocols | 服务器根据客户端请求切换协议 | 1xx 的状态码表示一个临时的响应, 仅由状态行和可选头构成, 由空行结尾. 对该类状态码, 不需要头部. 该类状态码在 HTTP/1.1 引入, 因此服务器禁止向 HTTP1.0 的客户端响应 1xx 状态码. 对于 100 (Continue) 状态码, 客户端应该继续它的请求. 这个过渡的响应用于告知客户端, 请求的初始部分已经被服务器收到, 并且没有被服务器拒绝. 客户端应该继续发送剩余的请求, 如果请求已经完成, 就忽略这个响应. 服务器必须在请求完成后发送一个最终的响应. 100 状态码的用途主要是, 允许客户端发送带请求体的请求前, 判断服务器是否愿意接收请求 (通过请求头). 在某些情况下, 如果服务器在不看请求体的情况下就拒绝请求时, 客户端仍然发送请求体是不恰当的或低效的. ### 2xx 成功状态码 | 状态码 | 状态码英文名称 | 描述 | | ---------- | ----------------------------- | ------------------------------------------------------------------------------------------------------- | | 200 | OK | 请求成功, 响应主体包含了具体的数据. 最常见, 一般 GET 和 POST 请求会返回此状态码. | | 201 | Created | 已创建, 一般 PUT 请求会返回此状态码. | | 202 | Accepted | 服务器已接收到请求, 但还未处理完成. | | 203 | Non-Authoritative Information | 非授权信息. 请求成功, 但元信息不在原始服务器上, 而是资源的一个副本. 若中间节点上有一份资源副本, 但无法或没有对它发出的与资源有关的元信息进行验证, 就会出现这种情况. | | 204 | No Content | 响应报文中无主体部分. 一般 DELETE 请求会返回此状态码. | | 205 | Reset Content | 负责告知浏览器清除当前页面中所有 HTML 元素. | | 206 | Partial Content | 成功执行一个部分或 Range 请求. 客户端可以在首部中指定请求某个范围内的文件. 该状态响应头部必须包含 Content-Range, Date, 以及 ETag 或 Content-Location. | 206 状态码一般是在下载大文件时会遇到, 它表示请求已成功, 并且主体包含所请求的数据区间, 该数据区间是在请求的 Range 首部指定. 下图中, 我的博客在获取音频文件时返回了 206 状态码. 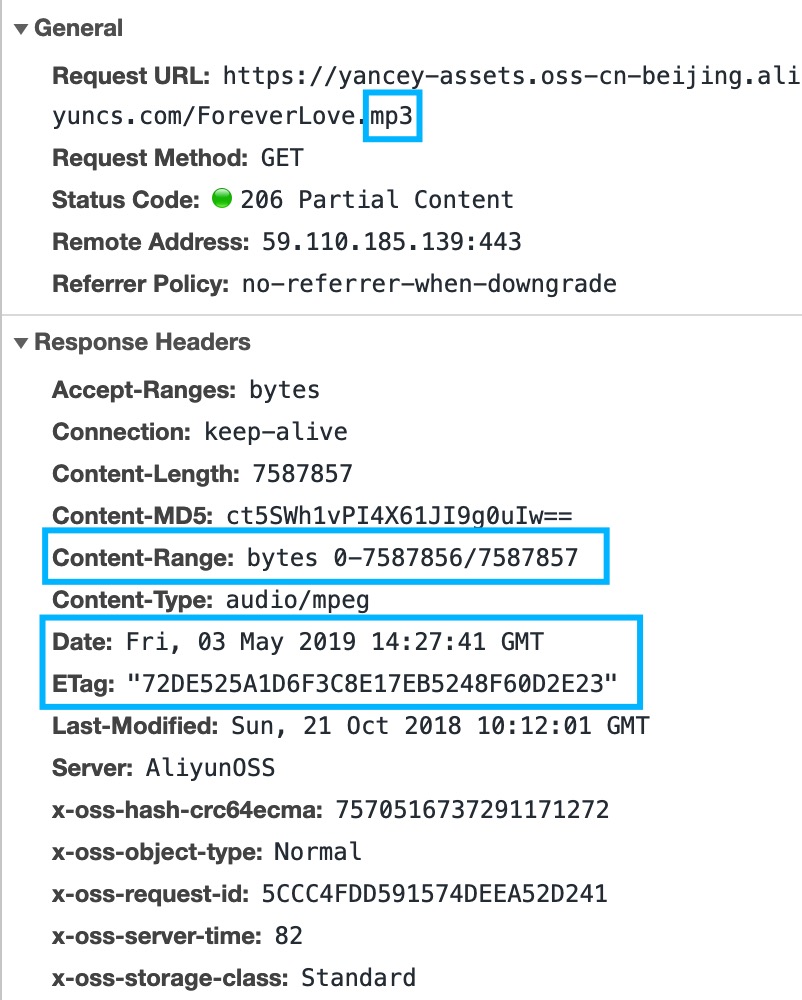 ### 3xx 重定向状态码 | 状态码 | 状态码英文名称 | 描述 | | ---------- | ------------------ | ------------------------------------------------------------------------------------------------------------------------ | | 300 | Multiple Choices | 返回一个有多个链接选项的页面, 用户自行选择要跳转的页面. (啊我想到的某站, 好涩 | | 301 | Moved Permanently | 永久重定向, 请求的 URL 已被移除. 响应的 Location 首部包含现在所处的位置. | | 302 | Found | 与 301 类似, 客户端本次应使用响应中的临时 URL, 将来的请求任使用以前的 URL. 响应的 Location 首部包含现在所处的位置. 浏览器看到这个 302 就知道这只是暂时的情况, 不会做缓存优化, 第二天还会访问原来的地址. | | 303 | See Other | 告知客户端使用另一个 URL 来获取资源. 其主要目的是, 允许 POST 请求的响应将客户端定向的某一个资源上去. | | 304 | Not Modified | 若客户端发起一个有条件的 GET 请求, 而资源未被修改, 可以使用该状态码说明资源未被修改. | | 305 | Use Proxy | 必须通过代理来访问这一资源, 代理有 Location 首部给出. 需要知道的是, 客户端接收到这一状态时, 不应该假定所有请求都经过代理. | | 307 | Temporary Redirect | 和 302 相同, 但重定向后请求里的方法和实体不允许变动, 含义比 302 更明确 | | 308 | Permanent Redirect | 不允许重定向后的请求变动, 但它是 301 永久重定向的含义 | ### 4xx 客户端错误状态码 | 状态码 | 状态码英文名称 | 描述 | | ---------- | ------------------------------------------------ | --------------------------------------------------------- | | 400 | Bad Request | 告知客户端它发送了一个错误的请求. | | 401 | Unauthorized | 与适当首部一同返回, 告知客户端在请求之前先进行认证. | | 403 | Forbidden | 请求被拒绝. | | 404 | Not Found | 服务器无法找到请求的 URL. | | 405 | Method Not Allowed | 客户端使用不支持的方法请求 URL. 应该在首部使用 Allow 告知客户端正确的方法. | | 406 | Not Acceptable | 服务器端无法提供与 Accept-Charset 以及 Accept-Language 消息头指定的值相匹配的响应 | | 407 | Proxy Authentication Required | 代理服务器要求客户端验证. | | 408 | Request Timeout | 客户端完成请求时间过长, 服务器可以关闭链接. | | 409 | Conflict | 服务器认为该请求可能引起冲突. 响应主体中应包含冲突的主体的描述. | | 410 | Gone | 与 404 类似, 只是服务器曾经拥有此资源, 后来被移除. | | 411 | Length Required | 服务器要求请求报文中包含 Content-Length 首部. | | 412 | Precondition Failed | 客户端发起条件请求, 其中有条件失败. | | 413 | Request Entity Too LargeRequest Entity Too Large | 客户端发送的主体部分比服务器能够活希望处理的要大. | | 414 | Request URI Too Long | URL 过长. | | 415 | Unsupported Media Type | 服务器无法理解或无法支持客户端发送的内容类型. | | 416 | Requested Range Not Satisfiable | 请求范围无效或无法满足. | | 417 | Expectation Failed | 请求首部包含 Expect 期望, 但服务器无法满足. | | 429 | Too Many Requests | 短时间内发送了太多请求 | | 431 | Request Header Fields Too Large | 请求头太大 | ### 5xx 服务端错误状态码 | 状态码 | 状态码英文名称 | 描述 | | ---------- | ------------------------ | ---------------------------------------------------------- | | 500 | Internal Server Error | 服务器遇到一个妨碍它提供服务的错误. | | 501 | Not Implemented | 客户端发起的请求超出服务器能力范围, 如使用了不支持的方法. | | 502 | Bad Gateway | 无效网关. 通常不是这上游服务器关闭, 而是使用了上游服务器不同意协议交换数据. | | 503 | Service Unavailable | 服务器暂时无法提供服务. 若服务器知道服务什么时间可以使用, 可以在响应头中加入 Retry-After 首部说明. | | 504 | Gateway Timeout | 于 408 类似, 只是这里的响应来自一个网关或代理, 它们在等待另一个服务器响应对其请求响应时超时. | | 505 | HTTP Version Not Support | 服务器收到的请求使用了它无法支持的协议版本. | | | | | ## Proxy 代理(Proxy)是 HTTP 协议中请求方和应答方中间的一个环节. 作为**中转站**. 既可以转发客户端的请求. 也可以转发服务器的应答. 常见的有四种: * 匿名代理: 完全**隐匿**了被代理的机器. 外界看到的只是代理服务器; * 透明代理: 顾名思义. 它在传输过程中是**透明开放**的. 外界既知道代理. 也知道客户端; * 正向代理: 靠近客户端. 代表客户端向服务器发送请求; * 反向代理: 靠近服务器端. 代表服务器响应客户端的请求; 比如 CDN 就是一种代理. 它代替源站服务器响应客户端的请求. 通常扮演着透明代理和反向代理的角色. 由于代理是在传输过程中插入了一个**中间层**, 它可以做很多事情: * 负载均衡: 把访问请求均匀分散到多台机器. 实现访问集群化; * 内容缓存: 暂存上下行的数据. 减轻后端的压力; * 安全防护: 隐匿 IP, 使用 WAF 等工具抵御网络攻击. 保护被代理的机器; * 数据处理: 提供压缩, 加密等额外的功能. ### HTTP 的代理服务 所谓的**代理服务**就是指服务本身不生产内容, 而是处于中间位置转发上下游的请求和响应, 具有双重身份: 面向下游的用户时, 表现为服务器, 代表源服务器响应客户端的请求; 而面向上游的源服务器时, 又表现为客户端, 代表客户端发送请求. 由于代理处在 HTTP 通信过程的中间位置, 相应地就对上屏蔽了真实客户端, 对下屏蔽了真实服务器, 简单的说就是**欺上瞒下**. 在这个中间层的**小天地**里就可以做很多的事情, 为 HTTP 协议增加更多的灵活性, 实现客户端和服务器的**双赢**. 代理最基本的一个功能是**负载均衡**. 因为在面向客户端时屏蔽了源服务器, 客户端看到的只是代理服务器, 源服务器究竟有多少台, 是哪些 IP 地址都不知道. 于是代理服务器就可以掌握请求分发的**大权**, 决定由后面的哪台服务器来响应请求. 代理中常用的负载均衡算法有随机, 轮询, 一致性 hash, 最近最少使用, 链接最少等等, 这些算法的目标都是尽量把外部的流量合理地分散到多台源服务器, 提高系统的整体资源利用率和性能. 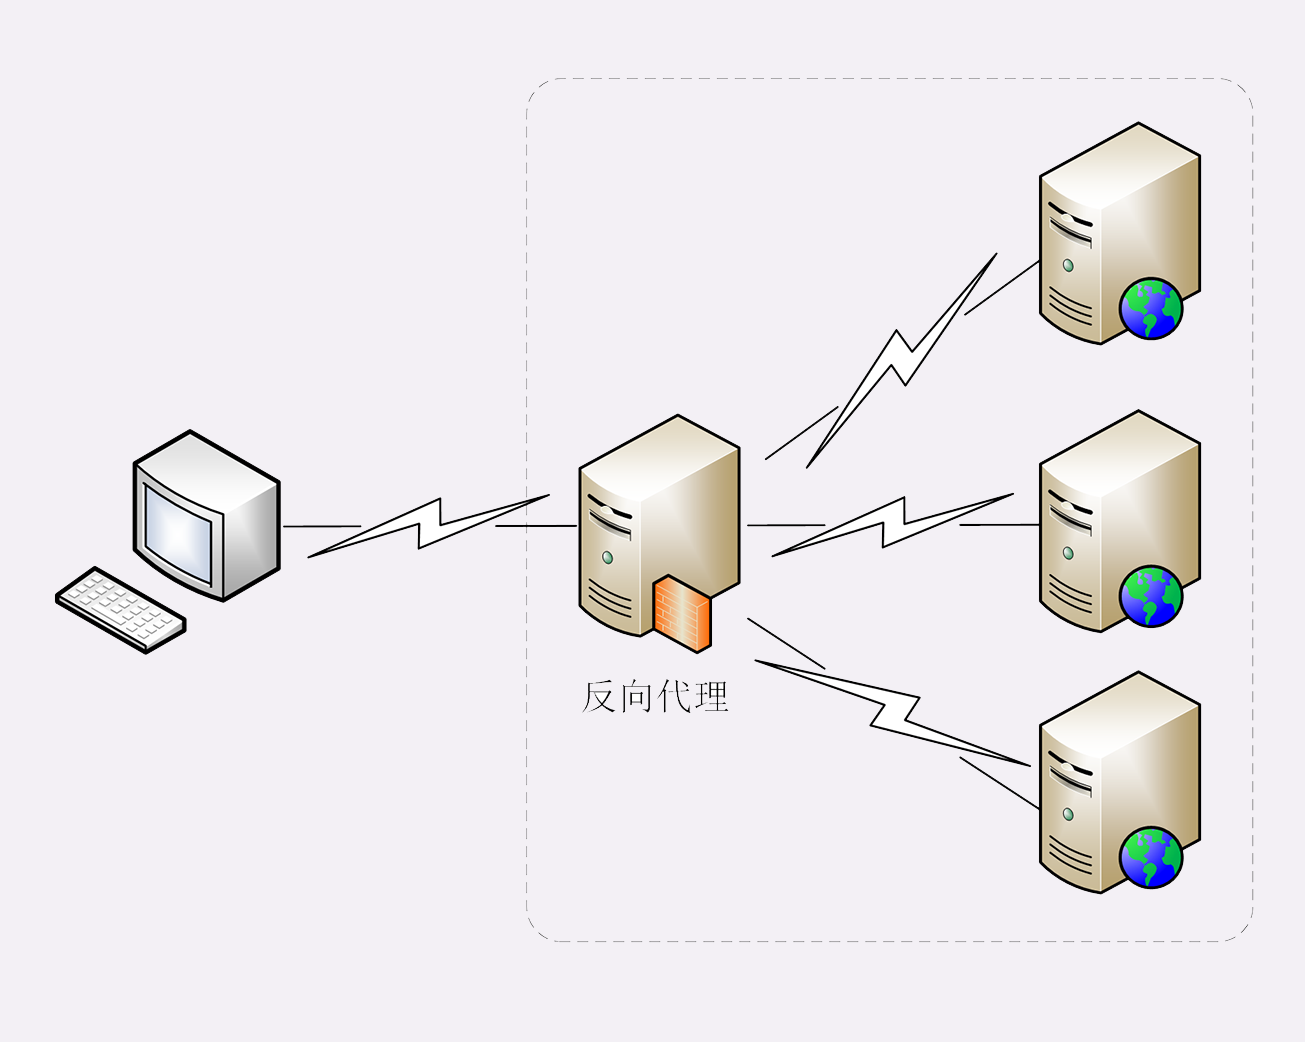 负载均衡的同时, 代理服务还可以执行更多的功能, 比如: * 健康检查: 使用**心跳**等机制监控后端服务器, 发现有故障就及时**踢出**集群, 保证服务高可用; * 安全防护: 保护被代理的后端服务器, 限制 IP 地址或流量, 抵御网络攻击和过载; * 加密卸载: 对外网使用 SSL/TLS 加密通信认证, 而在安全的内网不加密, 消除加解密成本; * 数据过滤: 拦截上下行的数据, 任意指定策略修改请求或者响应; * 内容缓存: 暂存, 复用服务器响应. 当然代理也有他的缺点, 比如代理会增加链路长度, 在代理上做一些复杂的处理. 会很耗费性能, 增加响应时间. ### 代理相关头字段 #### Via 代理隐藏了真实客户端和服务器, 如果双方想要获得这些**丢失**的原始信息,需要用字段 **Via** 标明代理的身份. Via 是一个通用字段, 请求头或响应头里都可以出现. 每当报文经过一个代理节点, 代理服务器就会把自身的信息追加到字段的末尾, 就像是经手人盖了一个章. 如果通信链路中有很多中间代理, 就会在 Via 里形成一个链表, 这样就可以知道报文究竟走过了多少个环节才到达了目的地. 例如下图中有两个代理: proxy1 和 proxy2, 客户端发送请求会经过这两个代理, 依次添加就是 **Via:proxy1, proxy2**, 等到服务器返回响应报文的时候就要反过来走, 头字段就是 **Via:proxy2, proxy1**. 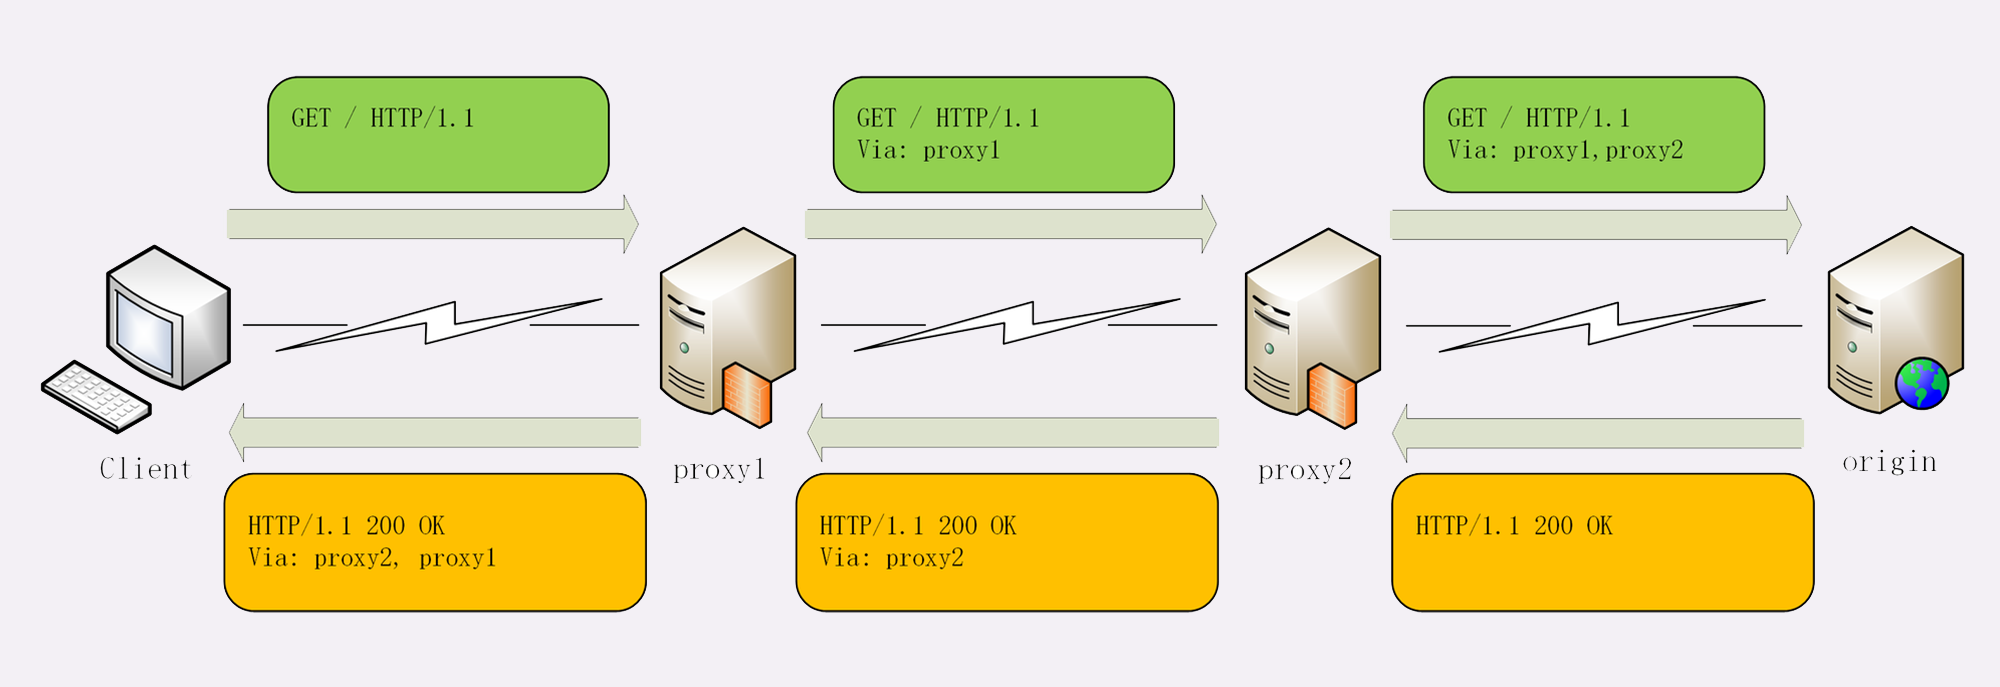 #### X-Forwarded-For 和 X-Real-IP Via 字段只解决了客户端和源服务器判断是否存在代理的问题, 还不能知道对方的真实信息. 但服务器的 IP 地址应该是保密的, 关系到企业的内网安全, 所以一般不会让客户端知道. 不过反过来, 通常服务器需要知道客户端的真实 IP 地址, 方便做访问控制, 用户画像, 统计分析. HTTP 标准里并没有为此定义头字段, 但常见的是 X-Forwarded-For 和 X-Real-IP. **X-Forwarded-For** 的字面意思是**为谁而转发**, 形式上和 **Via** 差不多, 也是每经过一个代理节点就会在字段里追加一个信息. 但 **Via** 追加的是代理主机名(或者域名), 而 **X-Forwarded-For** 追加的是请求方的 IP 地址. 所以, 在字段里最左边的 IP 地址就是客户端的地址. **X-Real-IP** 是另一种获取客户端真实 IP 的手段, 它的作用很简单, 就是记录客户端 IP 地址, 没有中间的代理信息, 相当于是 **X-Forwarded-For** 的简化版. 如果客户端和源服务器之间只有一个代理, 那么这两个字段的值就是相同的. 此外还有 **X-Forwarded-Host** 和 **X-Forwarded-Proto**, 它们的作用与 **X-Real-IP** 类似, 只记录客户端的信息, 分别是客户端请求的原始域名和原始协议名. ### 代理协议 有了 **X-Forwarded-For** 等头字段, 源服务器就可以拿到准确的客户端信息了. 但对于代理服务器来说它并不是一个最佳的解决方案. 因为通过 **X-Forwarded-For** 操作代理信息必须要解析 HTTP 报文头, 这对于代理来说成本比较高, 原本只需要简单地转发消息就好, 而现在却必须要费力解析数据再修改数据, 会降低代理的转发性能. 另一个问题是 **X-Forwarded-For** 等头必须要修改原始报文, 而有些情况下是不允许甚至不可能的(比如使用 HTTPS 通信被加密). 因此就出现了一个专门的**代理协议**(The PROXY protocol), 它由知名的代理软件 HAProxy 所定义. **代理协议**有 v1 和 v2 两个版本, v1 和 HTTP 差不多, 也是明文, 而 v2 是二进制格式. 以 v1 为例, 它相当于在 HTTP 报文头前又加了一个头. 例如下面的这个例子, 在 GET 请求行前多出了 PROXY 信息行, IP 地址类型是 TCP4, 客户端的真实 IP 地址是 1.1.1.1, 端口号是 55555; 而代理服务器的 IP 地址是 2.2.2.2, 端口号是 80. ```shell PROXY TCP4 1.1.1.1 2.2.2.2 55555 80\r GET / HTTP/1.1\r Host: www.xxx.com\r \r ``` ## 谈一谈 keep-alive 在 http 早期, 每个 http 请求都要求打开一个 tcp socket 连接, 并且使用一次之后就断开这个 tcp 连接. 使用 keep-alive 可以改善这种状态, 即在一次 TCP 连接中可以持续发送多份数据而不会断开连接. 通过使用 keep-alive 机制, 可以减少 tcp 连接建立次数, 也意味着可以减少 TIME_WAIT 状态连接, 以此提高性能和提高 httpd 服务器的吞吐率. 但是, keep-alive 并不是银弹, 长时间的 tcp 连接容易导致系统资源无效占用. 配置不当的 keep-alive, 有时比重复利用连接带来的损失还更大. 所以, 正确地设置 `keep-alive timeout` 时间非常重要. ### keep-alive timeout Httpd 守护进程, 一般都提供了 keep-alive timeout 时间设置参数. 比如 nginx 的 keepalive_timeout, 和 Apache 的 KeepAliveTimeout. 这个 keepalive_timout 时间值意味着:一个 http 产生的 tcp 连接在传送完最后一个响应后, 还需要 hold 住 keepalive_timeout 秒后, 才开始关闭这个连接. 当 httpd 守护进程发送完一个响应后, 理应马上主动关闭相应的 tcp 连接, 设置 keepalive_timeout 后, httpd 守护进程会想说:"再等等吧, 看看浏览器还有没有请求过来", 这一等, 便是 keepalive_timeout 时间. 如果守护进程在这个等待的时间里, 一直没有收到浏览发过来 http 请求, 则关闭这个 http 连接. ## HTTP/2 在之前 HTTP 有 0.9, 1.0, 1.1, 但为什么不叫 HTTP 2.0? 工作组特别给出了解释, 他们认为以前的 **1.0**, **1.1** 造成了很多的混乱和误解, 让人在实际的使用中难以区分差异, 所以就决定 HTTP 协议不再使用小版本号(minor version), 只使用大版本号(major version), 从今往后 HTTP 协议不会出现 HTTP/2.0, 2.1, 只会有 **HTTP/2**, **HTTP/3**. HTTP/2 首要目标是兼容 HTTP/1, 保留和 HTTP/1 一致的请求方法, URI, 状态码, 头字段等概念. 但在**语法**层做了**天翻地覆**的改造, 完全变更了 HTTP 报文的传输格式: * 使用二进制格式传输:HTTP1.x 协议以换行符作为纯文本的分隔符, 而 HTTP2 将所有传输的信息分割为更小的消息和帧, 并采用二进制格式对它们编码. * 头部压缩:使用 HPACK 算法 * 多路复用:多个请求可以共用一个 TCP 连接, 同一个请求和响应用一个流来表示, 并有唯一的流 ID 来标识. 多个请求和响应在 TCP 连接中可以乱序发送, 到达目的地后再通过流 ID 重新组建 * 服务器主动推送, 减少请求的延迟:除了对最初请求的响应外, 服务器还可以向客户端推送额外资源, 而无需客户端明确地请求 * 默认使用加密:虽然 HTTP/2 支持 HTTP, 但当下浏览器要求 HTTP/2 的必须使用 HTTPS, 因此在事实上 HTTP/2 必须是加密的. 下面是 HTTP, HTTPS, HTTP/2 的区别: 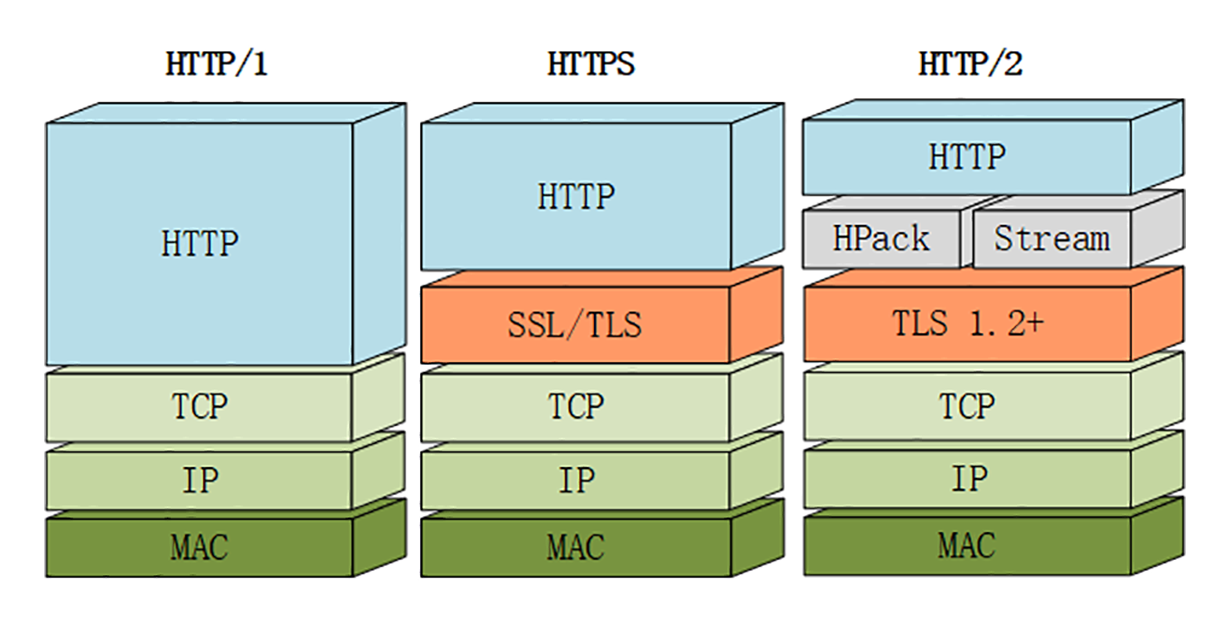 ### 头部压缩 HTTP/1 里可以用头字段 **Content-Encoding** 指定 Body 的编码方式, 比如用 gzip 压缩来节约带宽, 但报文的另一个组成部分 Header 却被无视了, 没有针对它的优化手段. 由于报文 Header 一般会携带几百字节甚至上千字节, 且请求响应报文里有很多字段值都是重复的, 非常浪费, **长尾效应**导致大量带宽消耗在了这些冗余度极高的数据上. 为此, HTTP/2 开发了专门的 **HPACK** 算法, 它是一个**有状态**的算法, 需要客户端和服务器各自维护一份**索引表**, 压缩和解压缩就是查表和更新表的操作; 此外还釆用哈夫曼编码来压缩整数和字符串, 可以达到 50%-90% 的高压缩率. 该算法的基本原理如下: * 客户端与服务端根据 [RFC 7541 的附录 A](https://datatracker.ietf.org/doc/html/rfc7541#appendix-A), 维护一份共同的静态字典(Static Table), 其中包含了常见头部名及常见头部名称与值的组合的代码; * 客户端和服务端根据先入先出的原则, 维护一份可动态添加内容的共同动态字典(Dynamic Table); * 客户端和服务端根据 [RFC 7541 的附录 B](https://datatracker.ietf.org/doc/html/rfc7541#appendix-B), 支持基于静态的霍夫曼编码(Huffman Coding). 为了方便管理和压缩, HTTP/2 废除了原有的起始行概念, 把起始行里面的请求方法, URI, 状态码等统一转换成了**头字段**的形式, 并且给这些**不是头字段的头字段**起了个特别的名字, **伪头字段**(pseudo-header fields). 而起始行里的版本号和错误原因短语因为没什么大用, 顺便也给废除了. 为了与**真头字段**区分开来, 这些**伪头字段**会在名字前加一个 **:**, 比如 **:authority**, **:method**, **:status**, 分别表示的是域名, 请求方法和状态码. 现在 HTTP 报文头就简单了, 全都是**Key-Value**形式的字段, 于是 HTTP/2 就为一些最常用的头字段定义了一个只读的**静态表**(Static Table). 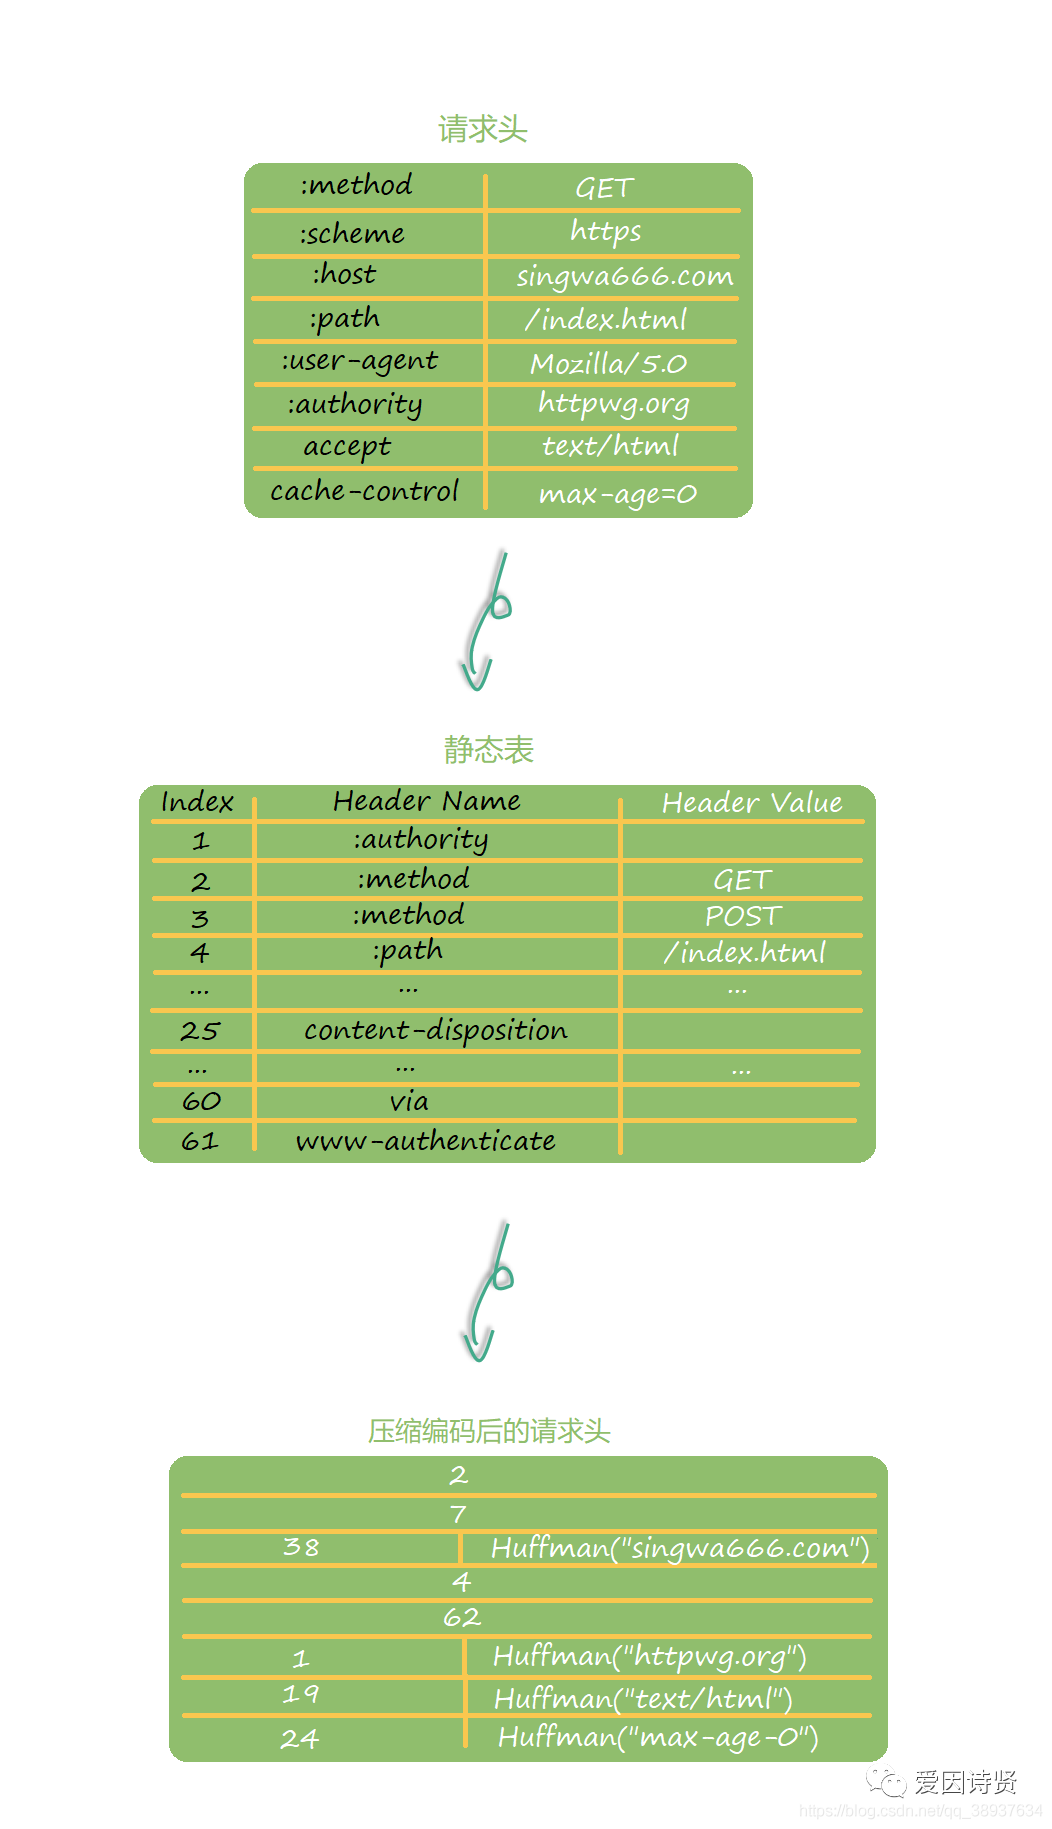 但如果表里只有 Key 没有 Value, 或者是自定义字段根本找不到该怎么办呢? 这就要用到**动态表**(Dynamic Table), 它添加在静态表后面, 结构相同, 但会在编码解码的时候随时更新. 比如说, 第一次发送请求时的**user-agent**字段长是一百多个字节, 用哈夫曼压缩编码发送之后, 客户端和服务器都更新自己的动态表, 添加一个新的索引号 **65**. 那么下一次发送的时候就不用再重复发那么多字节了, 只要用一个字节发送编号就好. 再谈一谈霍夫曼编码, 它的算法原理就是根据要处理的字符串, 获取每个 char 出现的频率, 出现频率**越高的**, 换算成哈夫曼编码(二进制)的长度就**越短**, 这便使编码之后的字符串的平均长度, 期望值降低, 从而达到无损压缩数据的目的. 霍夫曼树又称最优二叉树, 是一种带权路径长度最短的二叉树. 所谓树的带权路径长度, 就是树中所有的叶结点的权值乘上其到根结点的路径长度. [huffman visual](https://huffman.ooz.ie/) 这个网站用于根据字符串频率生成霍夫曼树, 并且把霍夫曼树绘制出来. 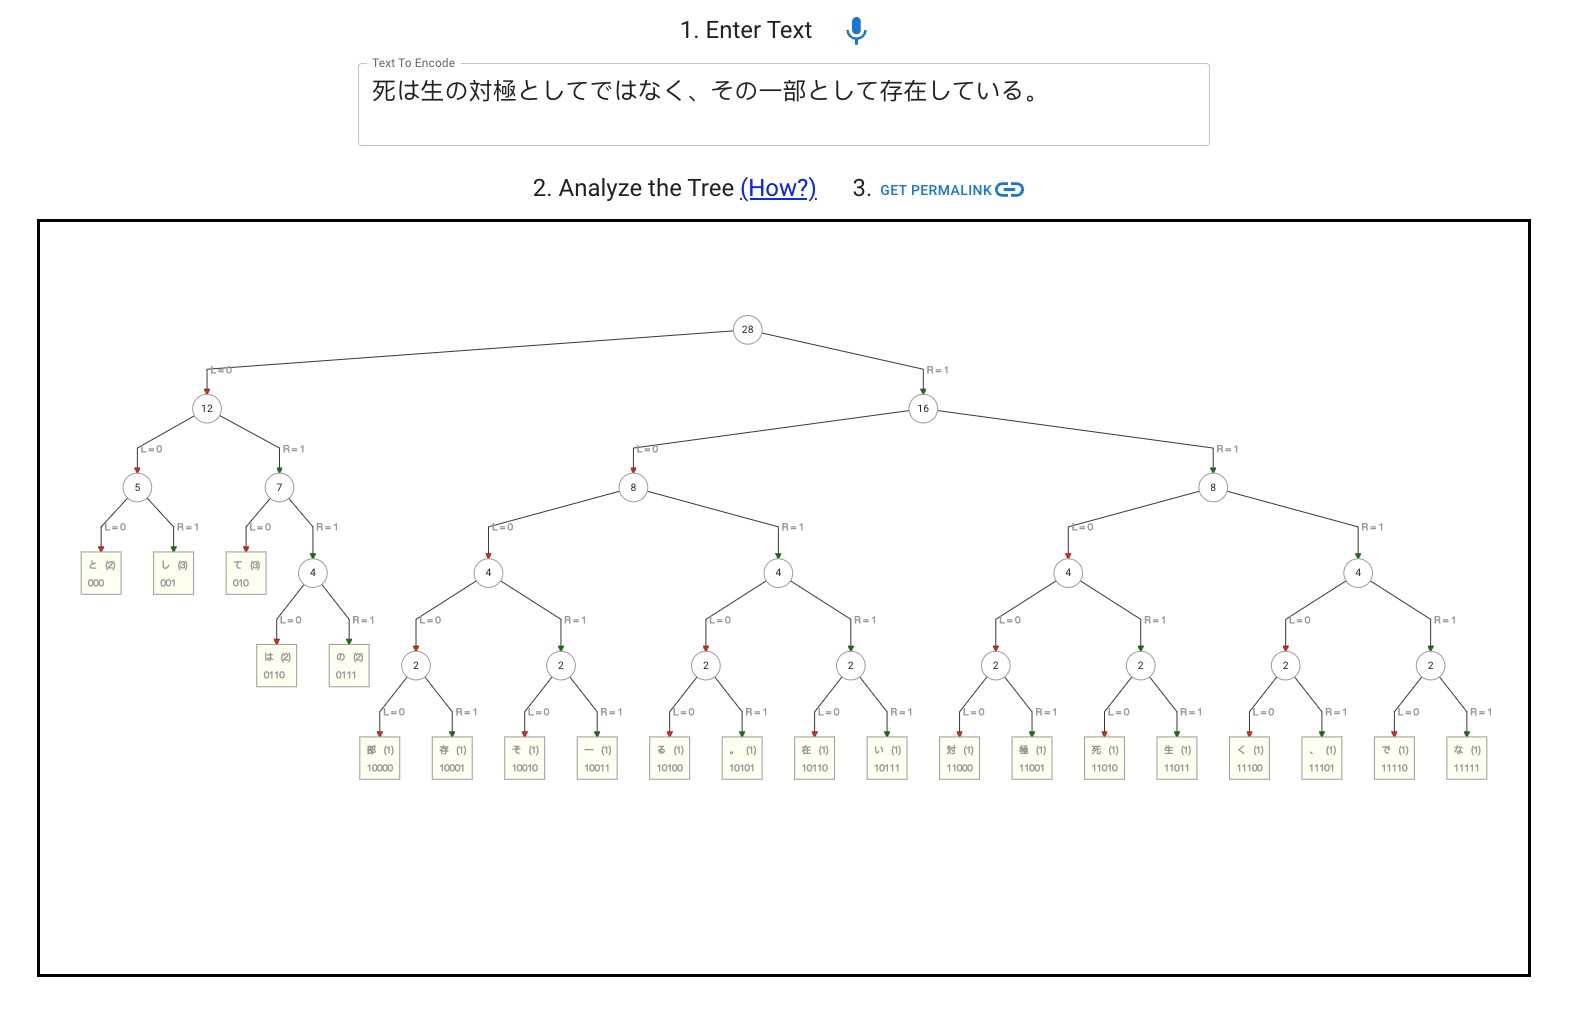 ### 二进制分帧 头部数据压缩之后, HTTP/2 就要把报文拆成二进制的帧准备发送. HTTP/1 使用的是纯文本形式的报文, 而 HTTP/2 不再使用肉眼可见的 ASCII 码, 转而使用二进制编码. 它把 TCP 协议的部分特性挪到了应用层, 把原来的 **Header+Body** 的消息**打散**为数个小片的二进制**帧**(Frame), 用 **HEADERS** 帧存放头数据, **DATA** 帧存放实体数据. 因此 HTTP/2 数据分帧后 **Header+Body** 的报文结构就完全消失了, 协议看到的只是一个个的**碎片**. 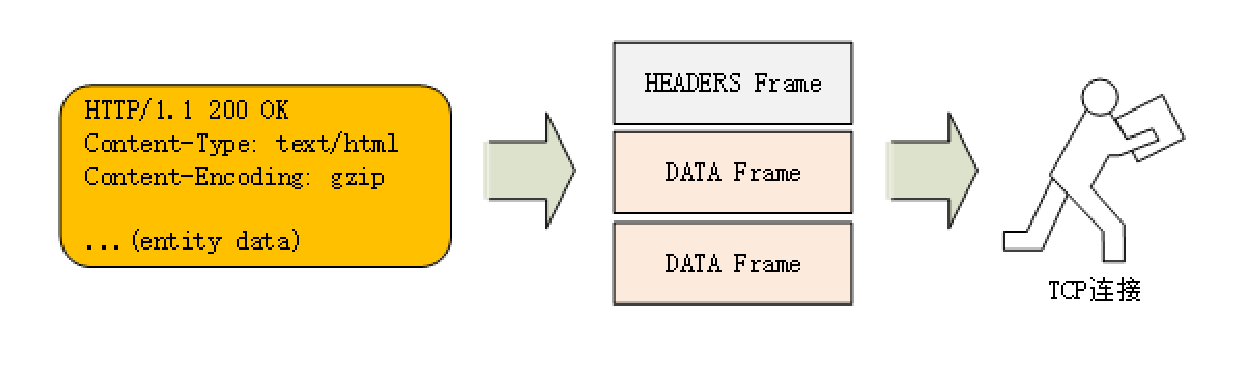 HTTP/2 的帧结构有点类似 TCP 的段或者 TLS 里的记录, 但报头很小, 只有 9 字节, 非常地节省(可以对比一下 TCP 头, 它最少是 20 个字节). 帧开头是 3 个字节的**长度**(但不包括头的 9 个字节), 默认上限是 **2**14, 最大是 **2**24, 也就是说 HTTP/2 的帧通常不超过 16K, 最大是 16M. 长度后面的一个字节是**帧类型**, 大致可以分成**数据帧**和**控制帧**两类, HEADERS 帧和 DATA 帧属于数据帧, 存放的是 HTTP 报文, 而 SETTINGS, PING, PRIORITY 等则是用来管理流的控制帧. HTTP/2 总共定义了 10 种类型的帧, 但一个字节可以表示最多 256 种, 所以也允许在标准之外定义其他类型实现功能扩展. 这就有点像 TLS 里扩展协议的意思了, 比如 Google 的 gRPC 就利用了这个特点, 定义了几种自用的新帧类型. 第 5 个字节是非常重要的**帧标志**信息, 可以保存 8 个标志位, 携带简单的控制信息. 常用的标志位有 **END_HEADERS** 表示头数据结束, 相当于 HTTP/1 里头后的空行(`\r`\ ), **END_STREAM** 表示单方向数据发送结束(即 EOS, End of Stream), 相当于 HTTP/1 里 Chunked 分块结束标志(`0\r`\ `\r`\ ). 报文头里最后 4 个字节是流标识符, 也就是帧所属的**流**, 接收方使用它就可以从乱序的帧里识别出具有相同流 ID 的帧序列, 按顺序组装起来就实现了虚拟的**流**. 流标识符虽然有 4 个字节, 但最高位被保留不用, 所以只有 31 位可以使用, 也就是说, 流标识符的上限是 2^31, 大约是 21 亿. 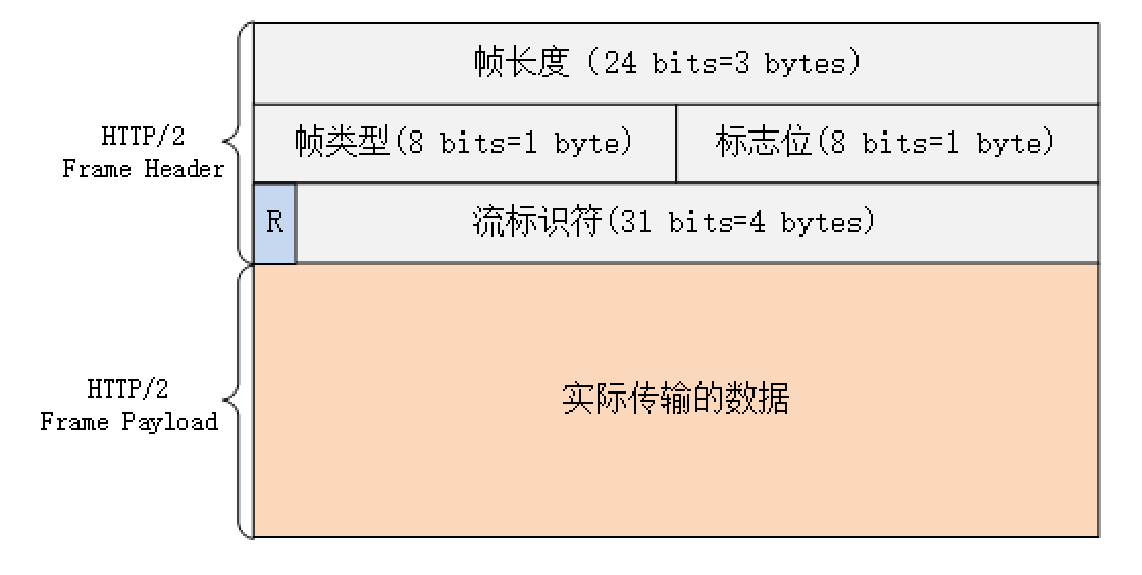 下面看一个实例分析: 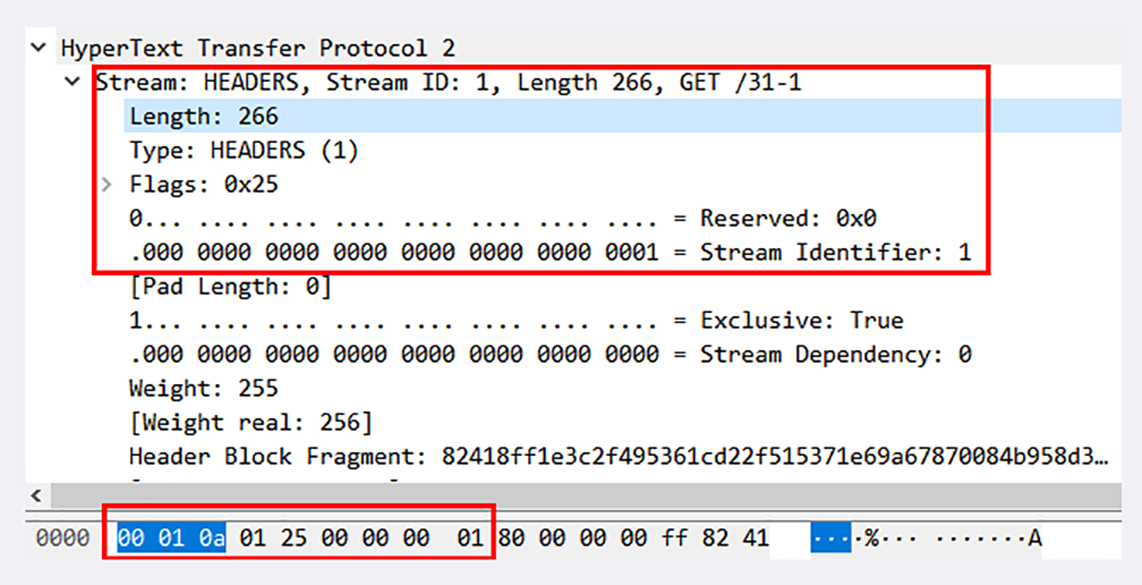 在这个帧里, 开头的三个字节是**00010a**, 表示数据长度是 266 字节. 帧类型是 1, 表示 HEADERS 帧, 负载(payload)里面存放的是被 HPACK 算法压缩的头部信息. 标志位是 0x25, 转换成二进制有 3 个位被置 1. PRIORITY 表示设置了流的优先级, END_HEADERS 表示这一个帧就是完整的头数据, END_STREAM 表示单方向数据发送结束, 后续再不会有数据帧(即请求报文完毕, 不会再有 DATA 帧 /Body 数据). 最后 4 个字节的流标识符是整数 1, 表示这是客户端发起的第一个流, 后面的响应数据帧也会是这个 ID, 也就是说在 `stream[1]` 里完成这个请求响应. ### 流与多路复用 上面说到二进制分帧传输的是一个个零散的碎片, 但到达后需要组装起来方可使用. HTTP/2 为此定义了一个**流**(Stream)的概念, 它是**二进制帧的双向传输序列**, 同一个消息往返的帧会分配一个唯一的流 ID. 在一条 Connection 中, 不同的流可以穿插传递(多路复用), 但是同一条流的达到顺序必须是有序的, 一个流内的帧必须有序. 这就是**传输中无序, 接收时组装**. 因为**流**是虚拟的, 实际上并不存在, 所以 HTTP/2 就可以在一个 TCP 连接上用**流**同时发送多个**碎片化**的消息, 这就是常说的**多路复用**(Multiplexing), 即多个往返通信都复用一个连接来处理. 在**流**的层面上看, 消息是一些有序的**帧**序列, 而在**连接**的层面上看, 消息却是乱序收发的**帧**. 多个请求 / 响应之间没有了顺序关系, 不需要排队等待, 也就不会再出现**队头阻塞**问题, 降低了延迟, 大幅度提高了连接的利用率. 当然 TCP 还是存在队头阻塞的情况.  HTTP/2 的流比起 HTTP/1 并发多个连接有如下几点优势: 与 HTTP/1 **并发多个连接**不同, HTTP/2 的**多路复用**特性要求对一个域名(或者 IP)只用一个 TCP 连接, 所有的数据都在这一个连接上传输, 这样不仅节约了客户端, 服务器和网络的资源, 还可以把带宽跑满, 让 TCP 充分**吃饱**. 在 HTTP/1 里的长连接, 虽然是双向通信, 但任意一个时间点实际上还是单向的: 上行请求时下行空闲, 下行响应时上行空闲, 再加上**队头阻塞**, 实际的带宽打了个**对折**还不止. 而在 HTTP/2 里, **多路复用**则让 TCP 开足了马力, **全速狂奔**, 多个请求响应并发, 每时每刻上下行方向上都有流在传输数据, 没有空闲的时候, 带宽的利用率能够接近 100%. 所以, HTTP/2 只使用一个连接, 就能抵得过 HTTP/1 里的五六个连接. HTTP/2 的流有如下特点: * 流是可并发的, 一个 HTTP/2 连接上可以同时发出多个流传输数据, 也就是并发多请求, 实现**多路复用**; * 客户端和服务器都可以创建流, 双方互不干扰; * 流是双向的, 一个流里面客户端和服务器都可以发送或接收数据帧, 也就是一个**请求 - 应答**来回; * 流之间没有固定关系, 彼此独立, 但流内部的帧是有严格顺序的; * 流可以设置优先级, 让服务器优先处理, 比如先传 HTML/CSS, 后传图片, 优化用户体验; * 流 ID 不能重用, 只能顺序递增, 客户端发起的 ID 是奇数, 服务器端发起的 ID 是偶数(客户端在一个连接里最多只能发出 **2**30, 也就是 10 亿个请求. 极端情况下, 如果 ID 用完了, 这个时候可以再发一个控制帧 **GOAWAY**, 真正关闭 TCP 连接); * 在流上发送**RST_STREAM**帧可以随时终止流, 取消接收或发送; * 第 0 号流比较特殊, 不能关闭, 也不能发送数据帧, 只能发送控制帧, 用于流量控制. #### 流的状态 为了更好地描述运行机制, HTTP/2 借鉴了 TCP, 根据帧的标志位实现流状态转换. * **idle**: 流空闲状态, 可以发送接收 HEADERS 帧; * **open**: 流开启状态, idle 发送或者接受 HEADERS 帧后, 状态变更为开启; * **half closed**: 发送包含 END_STREAM 帧的一端流转为本地半关闭 half closed(local), 表示客户端发送请求数据完毕, 等待服务端响应数据, 接受到服务端发送的 END_STREAM 进入 close 关闭状态. 接受 END_STREAM 帧的另一端称为远程半关闭状态 half closed(remote), 表示服务端知道客户端请求已经发送完毕, 处理结束后可以发送响应数据, 并发送 END_STREAM 到客户端, 进入 close 关闭状态; * **close**: 流的关闭状态. 除了 half closed 数据发送结束关闭外, 发送 RST_STREAM(发生错误或取消)也可关闭流. 刚才也说过, 流 ID 不能重用, 所以流的生命周期就是 HTTP/1 里的一次完整的**请求 - 应答**, 流关闭就是一次通信结束. 下一次再发请求就要开一个新流(而不是新连接), 流 ID 不断增加, 直到到达上限, 发送 **GOAWAY** 帧开一个新的 TCP 连接, 流 ID 就又可以重头计数.  #### 优先级控制 通过发送端向接收端发送优先级权重期待接收端给予资源分配支持, 接受端不保证一定遵守, 默认权重为 16. 优先级表达可以通过 HEADERS 或者单独发送 PRIORITY 帧实现.  #### 流依赖 客户端通过 PRIORITY 帧可以告诉服务端当前流所依赖的流, 形成流依赖树. 同一父级的各个字节点通过权重分配资源; 父级先分配资源传输结束后, 再分配子级资源. #### 流量控制 流量控制是保护接收方的机制, 通过配额机制实现. 发送端每发送数据后 window 窗口大小相应的减少. 当发送端收到接收端 WINDOW_UPDATE 桢后 window 窗口增加. window 等于 0 则不可以进行发送, 窗口初始值为 65535 字节.  ### 服务端推送 HTTP/2 还在一定程度上改变了传统的**请求 - 应答**工作模式, 服务器不再是完全被动地响应请求, 也可以新建**流**主动向客户端发送消息. 比如, 在浏览器刚请求 HTML 的时候就提前把可能会用到的 JS, CSS 文件发给客户端, 减少等待的延迟, 这被称为**服务器推送**(Server Push, 也叫 Cache Push). ### 强化安全 为兼容 HTTP/1, HTTP/2 可以使用 HTTP 也可以使用 HTTPS, 但浏览器要求 HTTP/2 必须使用 HTTPS, 因此**事实上**的 HTTP/2 是加密的. 不过, 为了区分**加密**和**明文**这两个不同的版本, HTTP/2 协议定义了两个字符串标识符:**h2** 表示加密的 HTTP/2, **h2c** 表示明文的 HTTP/2, 多出的那个字母 **c** 的意思是 **clear text**. #### 连接前言 由于 HTTP/2**事实上**是基于 TLS, TLS 握手成功之后, 客户端必须要发送一个**连接前言**(connection preface), 用来确认建立 HTTP/2 连接. 这个**连接前言**是标准的 HTTP/1 请求报文, 使用纯文本的 ASCII 码格式, 请求方法是特别注册的一个关键字**PRI**, 全文只有 24 个字节. 连接前言是个 Magic String, 总之就是写死的一个字符串. > PRISM 是棱镜的意思, 也就是斯诺登搞的那档子事. ```shell PRI * HTTP/2.0\r \r SM\r \r ``` #### 应用层协议协商 ALPN 在 HTTP/2 的末尾说一下**服务发现**. 在 URI 里用的都是 HTTPS 协议名, 没有版本标记, 浏览器怎么知道服务器支持 HTTP/2 呢? 为什么上来就能用 HTTP/2, 而不是用 HTTP/1 通信呢? 答案在 TLS 的扩展里, 有一个叫 **ALPN**(Application Layer Protocol Negotiation)的东西, 用来与服务器就 TLS 上跑的应用协议进行**协商**. 客户端在发起 **Client Hello** 握手的时候, 后面会带上一个 **ALPN** 扩展, 里面按照优先顺序列出客户端支持的应用协议. 服务器看到 ALPN 扩展以后就可以从列表里选择一种应用协议, 在 **Server Hello** 里也带上 **ALPN** 扩展, 告诉客户端服务器决定使用的是哪一种. 当然上面说道 HTTP/2 是可以不走 TLS 的, 故也不会有 ALPN 的过程. 它是通过头字段 `Connection: Upgrade` 配合 101 状态码来实现的.  ### HTTP/2 的缺点 以上就是 HTTP/2 的特点, 或者说优点. 但它仍然有一些不足. * TCP 的队头阻塞并没有彻底解决. 在 HTTP/2 中, 多个请求是跑在一个 TCP 管道中的. 但当 HTTP/2 出现丢包时, 整个 TCP 都要开始等待重传, 那么就会阻塞该 TCP 连接中的所有请求, 有可能不如 HTTP1.1 的多个 TCP 连接 TCP 以及 TCP+TLS 建立连接的延时 * 在移动网络中发生 IP 地址切换的时候, 下层的 TCP 必须重新建连, 要再次**握手**, 经历**慢启动**, 而且之前连接里积累的 HPACK 字典也都消失了, 必须重头开始计算, 导致带宽浪费和时延. * HTTP/2 对一个域名只开一个连接, 所以一旦这个连接出问题, 那么整个网站的体验也就变差了. * 多路复用导致服务器压力上升, 多路复用没有限制同时请求数. 请求的平均数量与往常相同, 但实际会有许多请求的短暂爆发, 导致瞬时 QPS 暴增 * 多路复用容易 Timeout 大批量的请求同时发送, 由于 HTTP2 连接内存在多个并行的流, 而网络带宽和服务器资源有限, 每个流的资源会被稀释, 虽然它们开始时间相差更短, 但却都可能超时. HTTP/2 不建议使用雪碧图, 这是因为 HTTP/2 中使用小颗粒化的资源, 优化了缓存, 而使用精灵图就相当于传输大文件, 但是大文件会延迟客户端的处理执行, 并且缓存失效的开销很昂贵, 很少数量的数据更新就会使整个精灵图失效, 需要重新下载(HTTP1 中使用精灵图是为了减少请求). HTTP/2 不建议使用内联资源, HTTP1 中使用内联资源是为了减少请求, 内联资源没有办法独立缓存, 破坏了 HTTP/2 的多路复用和优先级策略. HTTP/2 不建议使用域名分片, 域名分片是指利用多个域名和同一个 IP 地址建立 TCP 连接, 巧妙地避开了浏览器对并发连接数的限制 * 对于 HTTP/1 来说, 因为它没有多路复用, 所以这样能很好的缓解因为丢包重发而导致的队头阻塞 * 但对于 HTTP/2 来说, 多建立的 TCP 连接完全是浪费资源(两端的静态表和动态表, TCP 连接的成本等) 我们知道在 HTTP/2 中, 多个请求是跑在一个 TCP 管道中的, 如果其中任意一路数据流中出现了丢包的情况, 那么就会阻塞该 TCP 连接中的所有请求. 这不同于 HTTP/1.1, 使用 HTTP/1.1 时, 浏览器为每个域名开启了 6 个 TCP 连接, 如果其中的 1 个 TCP 连接发生了队头阻塞, 那么其他的 5 个连接依然可以继续传输数据. 所以随着丢包率的增加, HTTP/2 的传输效率也会越来越差. 有测试数据表明, 当系统达到了 2% 的丢包率时, HTTP/1.1 的传输效率反而比 HTTP/2 表现得更好. ## HTTP/3 HTTP/2 虽然使用**帧**, **流**, **多路复用**, 没有了**队头阻塞**, 但这些手段都是在应用层里, 而在下层, 也就是 TCP 协议里, 还是会发生**队头阻塞**. 在 HTTP/2 把多个**请求 - 响应**分解成流, 交给 TCP 后, TCP 会再拆成更小的段(segment)依次发送. 在网络良好的情况下, 包可以很快送达目的地. 但如果网络质量比较差, 像手机上网的时候, 就有可能会丢包. 而 TCP 为了保证可靠传输, 有个特别的**丢包重传**机制, 丢失的包必须要等待重新传输确认, 其他的包即使已经收到了, 也只能放在缓冲区里, 上层的应用拿不出来, 只能**干着急**. 总之, 队头阻塞的万恶之源还是出在 TCP 协议上. Google 在推 SPDY 的时候就已经意识到了这个问题, 于是就又发明了一个新的**QUIC**协议, 让 HTTP 跑在 QUIC 上而不是 TCP 上. 而这个**HTTP over QUIC**就是 HTTP 协议的下一个大版本, HTTP/3.  ### QUIC HTTP/3 有一个关键的改变, 那就是它把下层的 TCP**抽掉**了, 换成了 UDP. 因为 UDP 是无序的, 包之间没有依赖关系, 所以就从根本上解决了**队头阻塞**. UDP 是一个简单, 不可靠的传输协议, 只是对 IP 协议的一层很薄的包装, 和 TCP 相比, 它的结构更少. 而 HTTP/3 的官方传输层协议叫做 QUIC. QUIC 是集成了 TCP + HTTP/2 的多路复用 + TLS 等功能的一套综合协议. QUIC 基于 UDP, 而 UDP 是**无连接**的, 根本就不需要**握手**和**挥手**, 所以天生就要比 TCP 快. QUIC 也基于 UDP 实现了可靠传输, 保证数据一定能够抵达目的地. 它还引入了类似 HTTP/2 的**流**和**多路复用**, 单个**流**是有序的, 可能会因为丢包而阻塞, 但其他**流**不会受到影响. 为了防止网络上的中间设备(Middle Box)识别协议的细节, QUIC 全面采用加密通信, 可以很好地抵御窜改和**协议僵化**(ossification). 因为 TLS1.3 已于 2018 年正式发布, 所以 QUIC 就直接应用了 TLS1.3, 顺便也就获得了 0-RTT, 1-RTT 连接的好处. QUIC 内部**包含**了 TLS. 它使用自己的帧**接管**了 TLS 里的**记录**, 握手消息, 警报消息都不使用 TLS 记录, 直接封装成 QUIC 的帧发送, 省掉了一次开销. QUIC 里的包分为**长包**和**短包**两类,**长包**的第一个字节高位是 1, 格式比较完整,而短包只有目标连接 ID. QUIC 和 HTTP/3 的变长编码使用第一个字节的高两位决定整数的长度,最多是 8 个字节( 64 位),所以最大值是**2**62. HTTP/3 的帧不再需要 ENDJHEADERS 标志位和 CONTINUATION 帧,因为帧的长度足够大(**2**62) ,无论是多大的头都可以用一个帧传输.  ### QUIC 报文 QUIC 的基本数据传输单位是**包**(packet)和**帧**(frame), 一个包由多个帧组成, 包面向的是**连接**, 帧面向的是**流**. QUIC 使用**不透明**的**连接 ID** 来标记通信的两个端点, 客户端和服务器可以自行选择一组 ID 来标记自己, 这样就解除了 TCP 里连接对 **IP 地址 + 端口**(即常说的四元组)的强绑定, 支持**连接迁移**(Connection Migration). 比如你下班回家, 手机会自动由 4G 切换到 WiFi. 这时 IP 地址会发生变化, TCP 就必须重新建立连接. 而 QUIC 连接里的两端连接 ID 不会变, 所以连接在**逻辑上**没有中断, 它就可以在新的 IP 地址上继续使用之前的连接, 消除重连的成本, 实现连接的无缝迁移.  QUIC 里的流与 HTTP/2 的流非常相似, 也是帧的序列. 但 HTTP/2 里的流都是双向的, 而 QUIC 则分为双向流和单向流. QUIC 帧普遍采用变长编码, 最少只要 1 个字节, 最多有 8 个字节. 流 ID 的最大可用位数是 62, 数量上比 HTTP/2 的 **2**31 大大增加. 流 ID 还保留了最低两位用作标志, 第 1 位标记流的发起者, 0 表示客户端, 1 表示服务器;第 2 位标记流的方向, 0 表示双向流, 1 表示单向流. 所以 QUIC 流 ID 的奇偶性质和 HTTP/2 刚好相反, 客户端的 ID 是偶数, 从 0 开始计数. ### QUIC 如何实现可靠性的 * 纠错码: QUIC协议使用了类似于UDP协议的“单包丢失即所有数据包需要重新传输”的原则,并通过引入 FEC(Forward Error Correction)(前向纠错)机制根据一定的算法来构造冗余数据包以恢复丢失的数据包,提高数据传输可靠性。 * 拥塞控制: 为了避免网络的拥塞问题,QUIC协议在传输过程中引入了拥塞控制机制,且QUIC中的拥塞控制是面向连接的,即在连接的每个数据流上都运行拥塞控制算法,以保证连接中每个数据流可以公平分享网络带宽,从而使整个传输过程更加可靠。 * 流量控制: 与拥塞控制相对,流量控制主要是限制每个连接上的数据流的发送速率,避免过度发送对方无法处理的数据而导致数据的丢失或降低网络质量。QUIC协议中流量控制也是基于面向流的,即在每个数据流上单独进行流量控制处理。 ### HTTP/3 协议 因为 QUIC 本身就已经支持了加密, 流和多路复用, 所以 HTTP/3 的工作减轻了很多, 把流控制都交给 QUIC 去做. 调用的不再是 TLS 的安全接口, 也不是 Socket API, 而是专门的 QUIC 函数. HTTP/3 里仍然使用流来发送**请求 - 响应**, 但它自身不需要像 HTTP/2 那样再去定义流, 而是直接使用 QUIC 的流, 相当于做了一个**概念映射**. HTTP/3 里的**双向流**可以完全对应到 HTTP/2 的流, 而**单向流**在 HTTP/3 里用来实现控制和推送, 近似地对应 HTTP/2 的 0 号流. 由于流管理被**下放**到了 QUIC, 所以 HTTP/3 里帧的结构也变简单了. 帧头只有两个字段:类型和长度, 而且同样都采用变长编码, 最小只需要两个字节. HTTP/3 里的帧仍然分成数据帧和控制帧两类, HEADERS 帧和 DATA 帧传输数据, 但其他一些帧因为在下层的 QUIC 里有了替代, 所以在 HTTP/3 里就都消失了, 比如 RST_STREAM, WINDOW_UPDATE, PING 等.  头部压缩算法在 HTTP/3 里升级成了 **QPACK**, 使用方式上也做了改变. 虽然也分成静态表和动态表, 但在流上发送 HEADERS 帧时不能更新字段, 只能引用, 索引表的更新需要在专门的单向流上发送指令来管理, 解决了 HPACK 的**队头阻塞**问题. 另外, QPACK 的字典也做了优化, 静态表由之前的 61 个增加到了 98 个, 而且序号从 0 开始, 也就是说 **:authority** 的编号是 0. ### HTTP/3 服务发现 和 HTTP/2 一样, HTTP/3 也需要支持服务发现功能. HTTP/3 没有指定默认的端口号, 也就是说不一定非要在 UDP 的 80 或者 443 上提供 HTTP/3 服务. 那么, 该怎么**发现** HTTP/3 呢? 这就要用到 HTTP/2 里的**扩展帧**了. 浏览器需要先用 HTTP/2 协议连接服务器, 然后服务器可以在启动 HTTP/2 连接后发送一个 **Alt-Svc** 帧, 包含一个 **h3=host:port** 的字符串, 告诉浏览器在另一个端点上提供等价的 HTTP/3 服务. 浏览器收到 **Alt-Svc** 帧, 会使用 QUIC 异步连接指定的端口, 如果连接成功, 就会断开 HTTP/2 连接, 改用新的 HTTP/3 收发数据. ### HTTP/3 的挑战 通过上面的分析, 我们相信在技术层面, HTTP/3 是个完美的协议. 不过要将 HTTP/3 应用到实际环境中依然面临着诸多严峻的挑战, 这些挑战主要来自于以下三个方面. 第一, 从目前的情况来看, 服务器和浏览器端都没有对 HTTP/3 提供比较完整的支持. Chrome 虽然在数年前就开始支持 Google 版本的 QUIC, 但是这个版本的 QUIC 和官方的 QUIC 存在着非常大的差异. 第二, 部署 HTTP/3 也存在着非常大的问题. 因为系统内核对 UDP 的优化远远没有达到 TCP 的优化程度, 这也是阻碍 QUIC 的一个重要原因. 第三, 中间设备僵化的问题. 这些设备对 UDP 的优化程度远远低于 TCP, 据统计使用 QUIC 协议时, 大约有 3% - 7% 的丢包率. ## 总结 ### HTTP 的特点 * HTTP 是灵活可扩展的, 可以任意添加头字段实现任意功能; * HTTP 是可靠传输协议, 基于 TCP/IP 协议尽量保证数据的送达; * HTTP 是应用层协议, 比 FTP, SSH 等更通用功能更多, 能够传输任意数据; * HTTP 使用了请求 - 应答模式, 客户端主动发起请求, 服务器被动回复请求; * HTTP 本质上是无状态的, 每个请求都是互相独立, 毫无关联的, 协议不要求客户端或服务器记录请求相关的信息. 而 TCP 协议是有状态的, 一开始处于 CLOSED 状态, 连接成功后是 ESTABLISHED 状态, 断开连接后是 FIN-WAIT 状态, 最后又是 CLOSED 状态. 这些状态就需要 TCP 在内部用一些数据结构去维护. ## HTTP 优缺点 * HTTP 最大的优点是简单, 灵活和易于扩展; * HTTP 拥有成熟的软硬件环境, 应用的非常广泛, 是互联网的基础设施; * HTTP 是无状态的, 可以轻松实现集群化, 扩展性能, 但有时也需要用 Cookie 技术来实现有状态; * HTTP 是明文传输, 数据完全肉眼可见, 能够方便地研究分析, 但也容易被窃听; * HTTP 是不安全的, 无法验证通信双方的身份, 也不能判断报文是否被篡改; * HTTP 的性能不算差, 但不完全适应现在的互联网, 还有很大的提升空间(队头阻塞). 欢迎关注我的微信公众号: 进击的前端  ## 参考 《图解 HTTP》 -- 上野 宣 [express 中 cookie 的使用和 cookie-parser 的解读](https://segmentfault.com/a/1190000004139342) [谈谈 cookie](http://barryliu1995.studio/2017/10/11/%E8%B0%88%E8%B0%88cookie) [把 cookie 聊清楚](https://juejin.im/post/59d1f59bf265da06700b0934) [[读] 这一次,让我们再深入一点 - HTTP 报文](https://juejin.im/post/5a4f782c5188257326469d7c) [HTTP 状态码详解之 100](https://blog.lyz810.com/article/2016/11/http-statuscode-100-continue/) [你所知道的 3xx 状态码](https://aotu.io/notes/2016/01/28/3xx-of-http-status/index.html) --- Source: https://yanceyleo.com/post/efd566e9-4ee3-4ee2-8448-628414659480 Published: 2019-06-03 Tags: HTTP